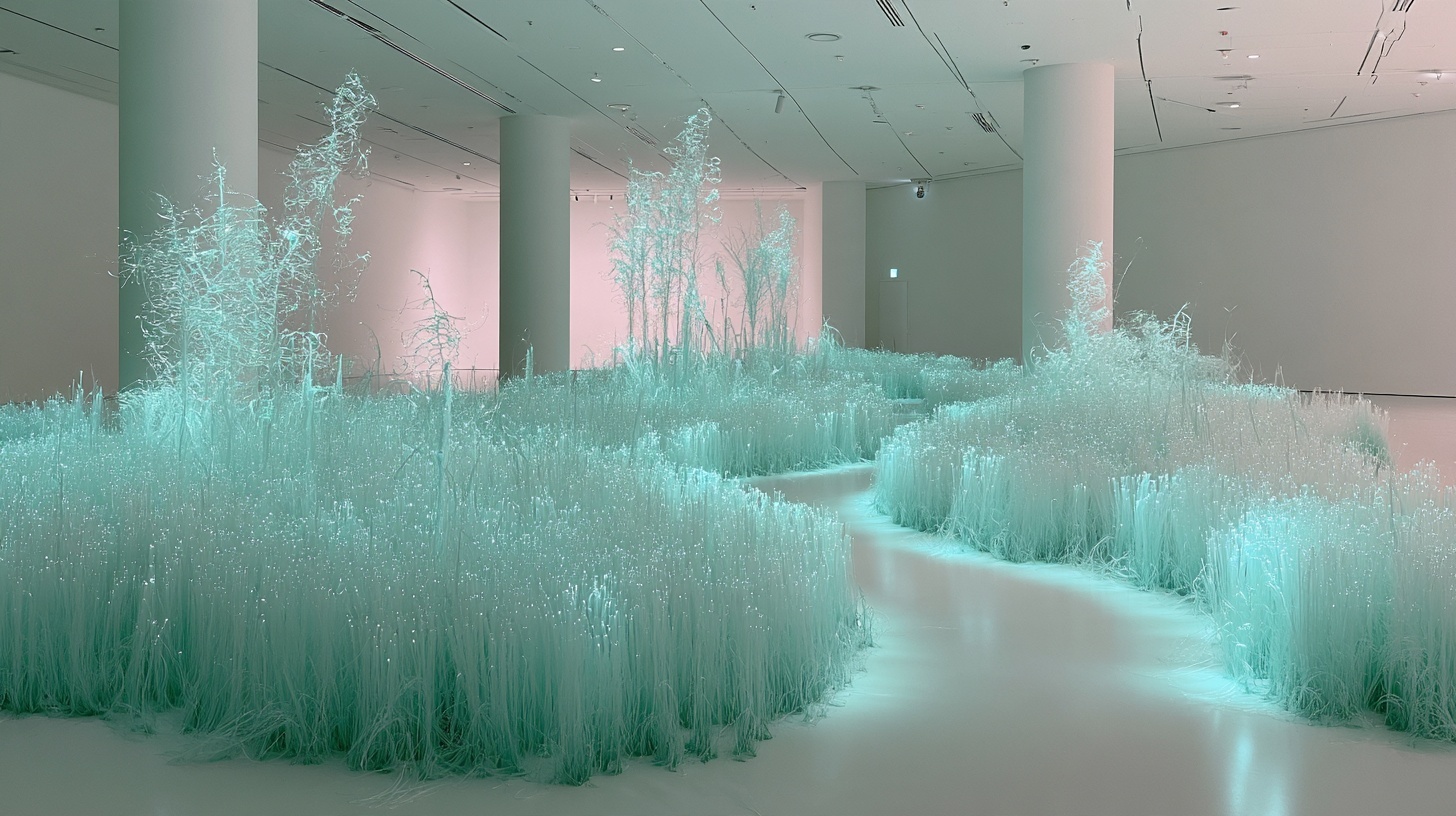
빛의 정원
빛나는 가닥과 관람 동선이 반영됐다. 실제 재료와 시공 방식은 정해지지 않았다.
흰 미술관 전시장 바닥에서 가느다란 광섬유 수천 가닥이 풀처럼 자란다, 끝부분만 은은하게 푸른빛으로 빛난다, 관객이 걸어갈 수 있는 구불구불한 길, 낮은 눈높이에서 본 전경, 생태와 기술의 관계를 다루는 설치미술 구상 --ar 16:9
사람을 거의 닮았지만 일부가 어긋나면, 친근함이 낯섦과 불편함으로 바뀔 수 있다.
모리 마사히로가 1970년에 제안한 언캐니 밸리 가설이다.
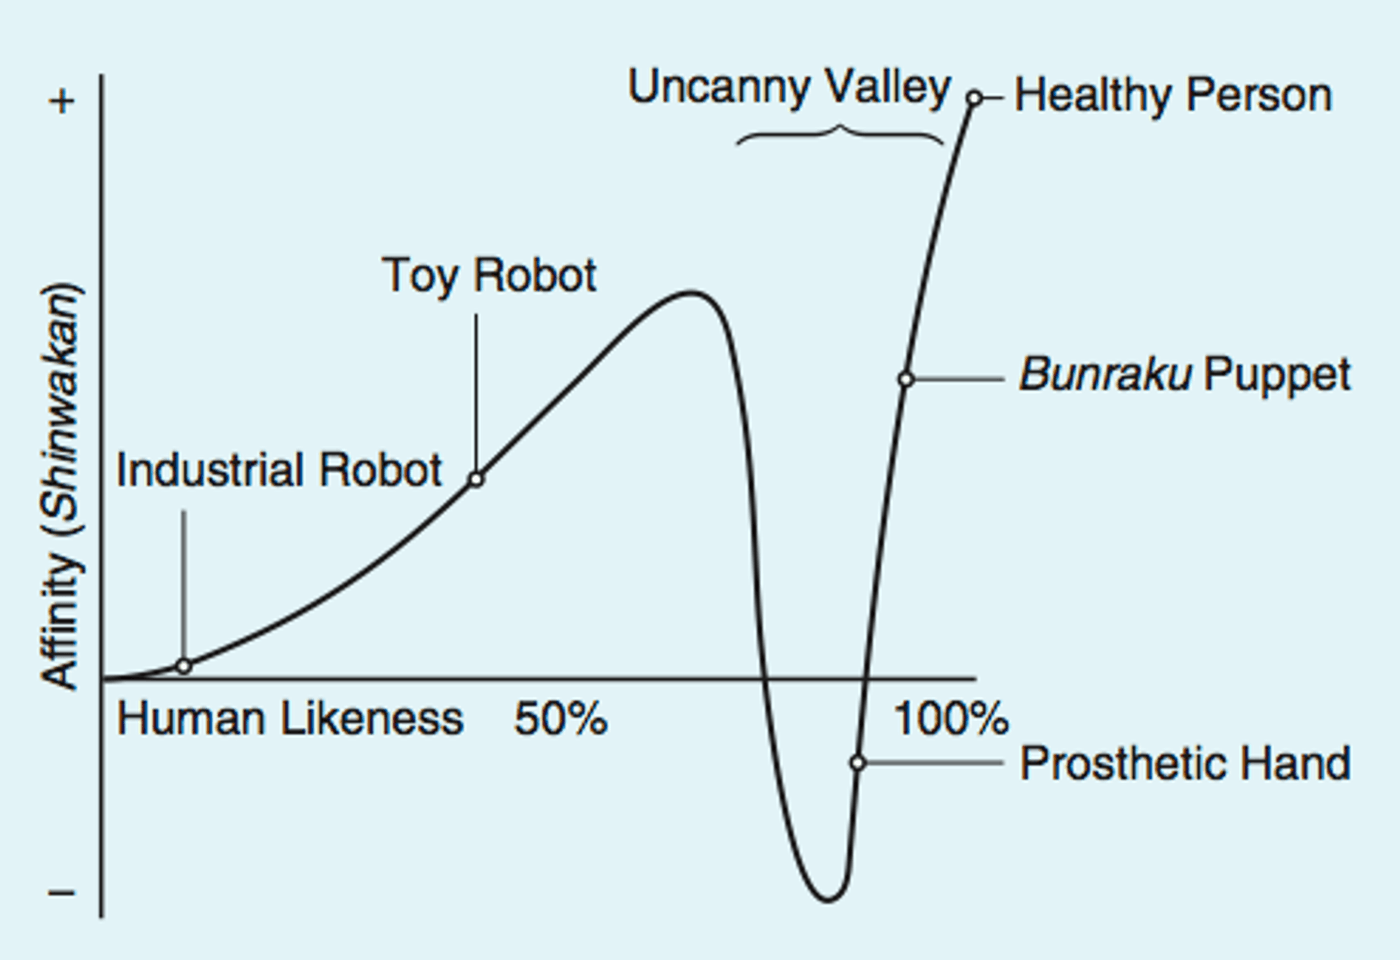
닮은 정도가 높아져도 호감이 계속 오르지는 않는다. ‘거의 사람 같은데 어딘가 다름’에서 반응이 떨어질 수 있다.
피부는 실사 같은데 눈·치아가 어색하거나, 얼굴과 움직임의 자연스러움이 다르면 낯설게 느낄 수 있다.
친근함을 원하면 표현의 일관성을 살핀다. 낯섦을 다루는 작품이라면 그 어긋남을 의도적으로 선택할 수 있다.
이 곡선은 설명을 위한 가설이다. 앞의 연도별 얼굴 이미지가 골짜기를 통과했음을 측정한 그래프는 아니다.
원리 보충 · VAE · 2013 공개 / ICLR 2014
원자료 PDF 열기픽셀 하나하나 대신, 이미지의 특징을 담은 작은 잠재 공간을 학습합니다.
인코더로 요약하고, 디코더로 다시 펼칩니다.
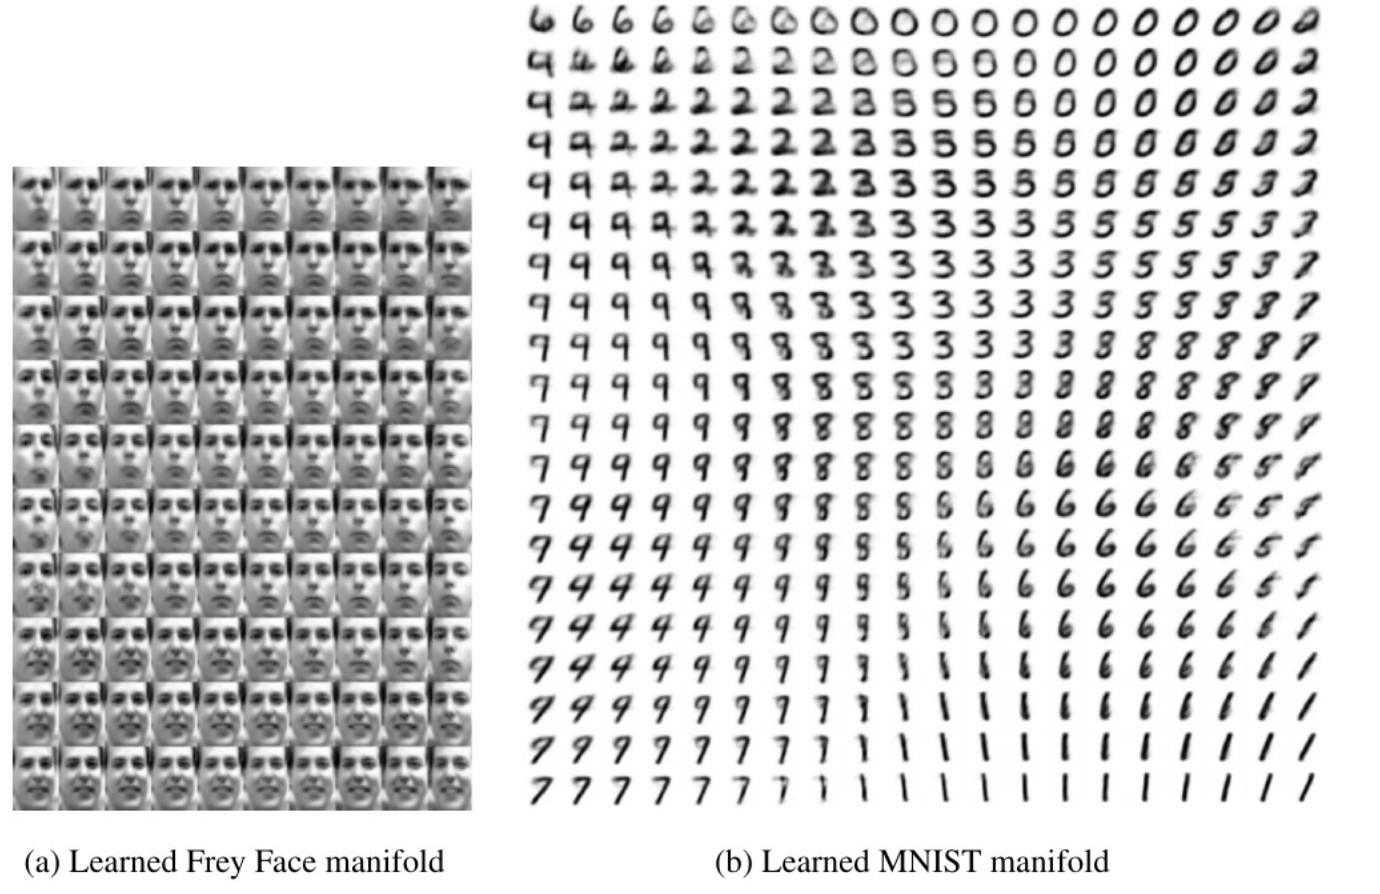
인코더는 특징을 잠재 공간의 분포로 옮깁니다. 디코더는 그곳에서 뽑은 값을 이미지로 펼칩니다.
각 칸은 다른 잠재 좌표에서 만든 결과입니다. 얼굴의 표정과 숫자의 형태가 조금씩 이어져 달라집니다.
“이미지 ↔ 잠재 공간”의 발상은 뒤에서 보는 LDM의 압축·복원 단계와 연결됩니다.
구글 교육 자료는 ‘지폐 만들기’로 두 신경망의 경쟁을 설명한다. 아래 두 장면에서 왼쪽의 생성 지폐가 어떻게 변하는지 보자.
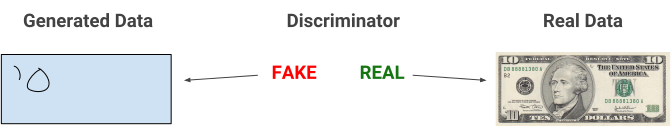
생성기는 무작위 입력에서 가짜 이미지를 만들고, 판별기는 실제 자료와 비교해 진짜/가짜를 가린다.
판별 결과가 생성기에 학습 신호로 돌아간다. ‘경쟁하며 개선’이 GAN의 핵심이다.
Hugging Face의 실습 그림이다. 왼쪽에서 오른쪽으로 갈수록 고양이 사진에 노이즈가 많이 섞여 원래 모습이 사라진다.
학습할 때 모델은 노이즈가 섞인 이미지에서 어떤 노이즈를 제거할지 예측하고, 실제 섞은 노이즈와 비교해 오류를 줄인다.
생성할 때는 무작위 노이즈에서 시작해 이 과정을 여러 번 반복하며 새 이미지를 만든다. 원본 사진 한 장을 되돌리는 작업은 아니다.
원리 보충 · CLIP · ICML 2021
원자료 PDF 열기인터넷에서 모은 이미지·설명글 4억 쌍을 이용해, 어떤 글이 어떤 이미지와 맞는지 학습했습니다.
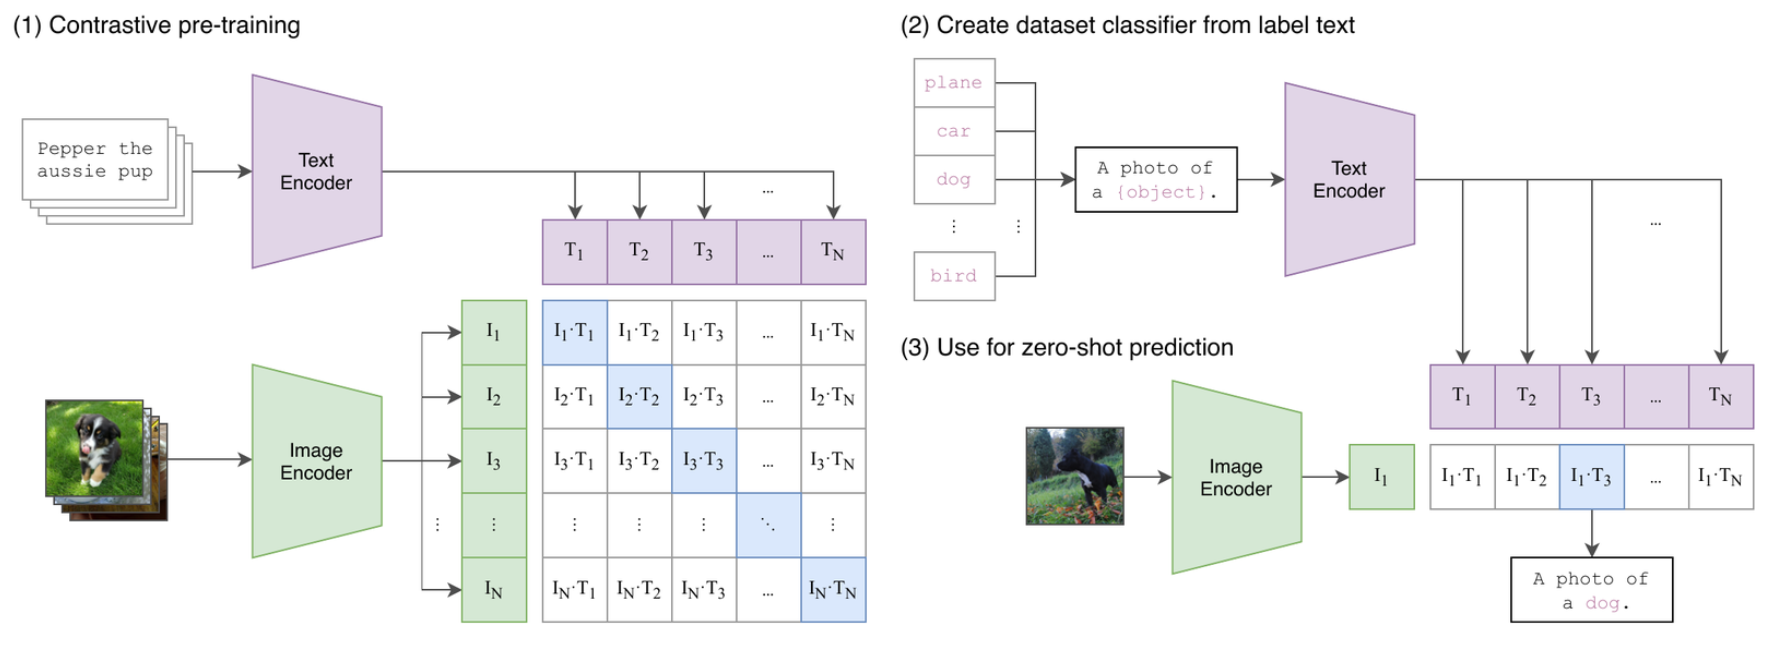
Text Encoder는 글을, Image Encoder는 이미지를 특징 값으로 바꿉니다.
가운데 표의 대각선은 맞는 이미지·글 쌍입니다. 맞는 짝은 가깝게, 틀린 짝은 멀게 학습합니다.
우리가 쓴 말과 시각적 특징을 연결하는 연구입니다. 대상·재질·공간을 구체적으로 적는 이유와 연결됩니다.
CLIP은 이미지를 직접 만드는 모델이 아니라, 글과 이미지의 관계를 학습하는 모델입니다.
원리 보충 · LDM · 2021 공개 / CVPR 2022
원자료 PDF 열기압축·노이즈 제거·복원을 묶어, 픽셀 공간에서 직접 계산하는 부담을 줄였습니다.
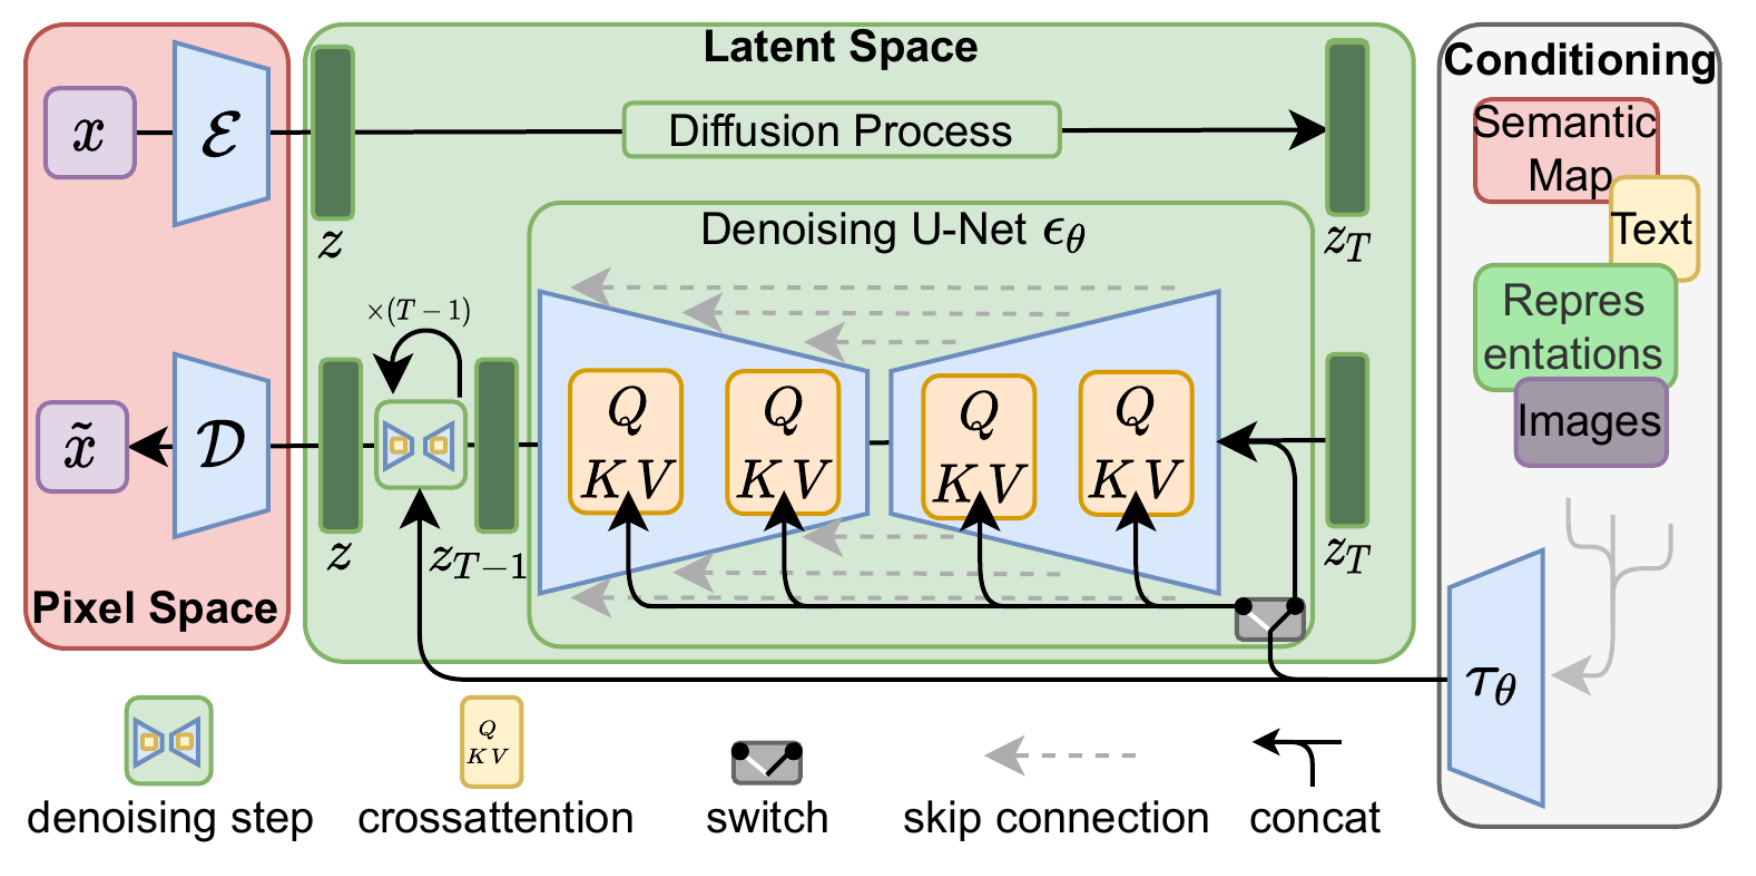
인코더가 이미지를 잠재 표현으로 옮깁니다. 모델은 이 압축된 공간에서 계산합니다.
텍스트 등의 조건을 참고하며 잠재 공간의 노이즈를 단계적으로 줄입니다.
디코더가 계산한 잠재 표현을 우리가 보는 이미지로 펼칩니다. Stable Diffusion의 바탕이 된 구조입니다.
압축 공간에서 계산하되, 최종 결과는 이미지로 다시 펼쳐서 보여줍니다.
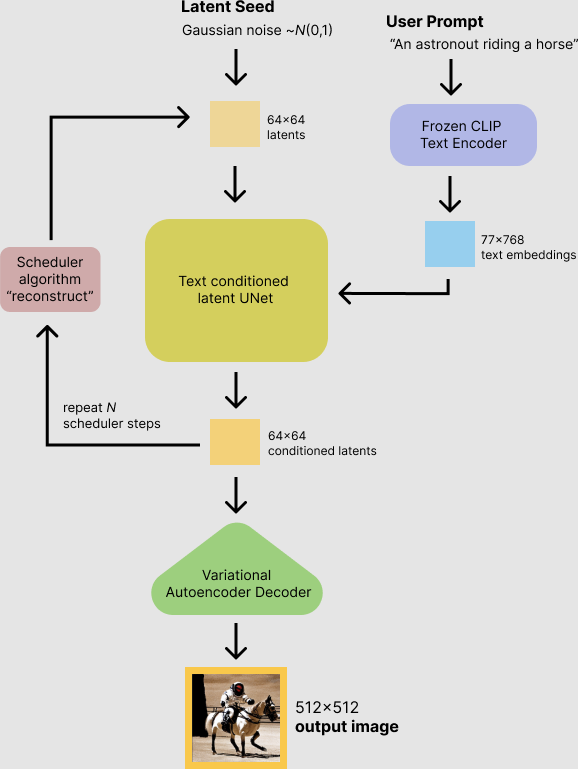
왼쪽 위 Latent Seed는 무작위 출발점, 오른쪽 위 User Prompt는 우리가 쓴 문장이다.
중앙의 모델이 텍스트 조건을 참고하며 노이즈를 여러 단계에 걸쳐 줄인다.
아래쪽 디코더가 계산한 결과를 우리가 보는 이미지로 바꾼다.
같은 문장을 써도 출발점과 설정이 다르면 결과가 달라질 수 있다. 그래서 생성 → 비교 → 수정을 반복한다.
원리 보충 · ControlNet · ICCV 2023
원자료 PDF 열기문장만으로 자세·배치·윤곽을 지정하기 어렵다면, 그림의 구조를 별도 조건으로 전달할 수 있습니다.
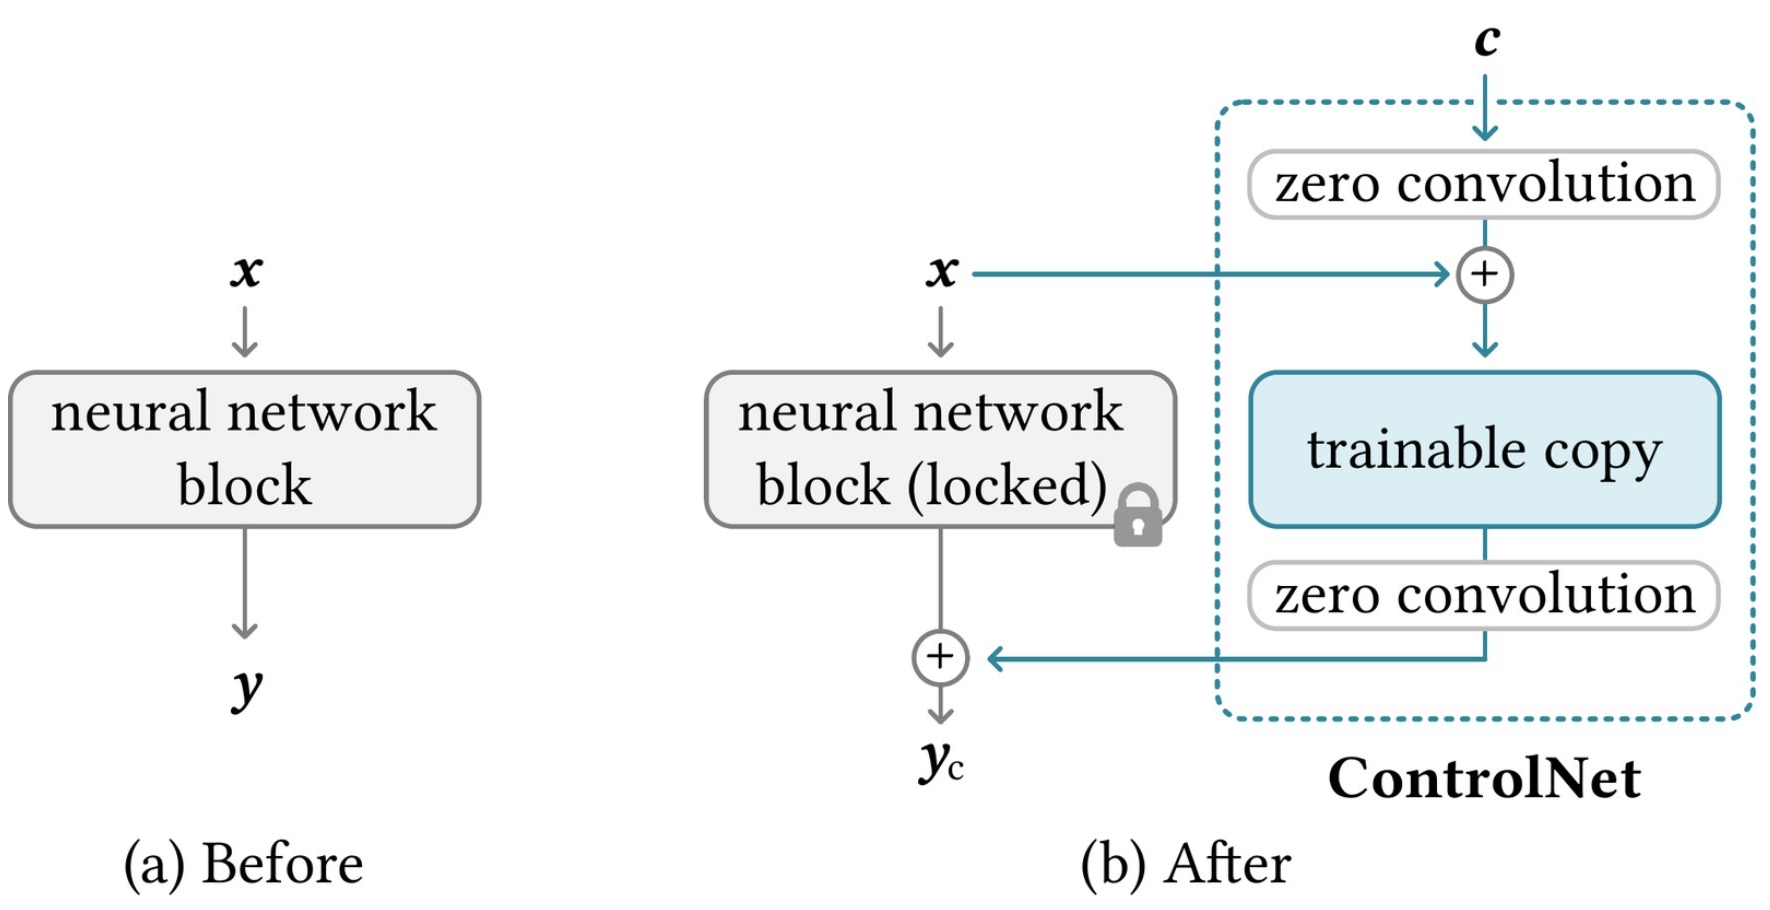
그림 오른쪽의 locked 블록은 기존 모델의 가중치를 고정한 부분입니다.
trainable copy는 윤곽선·자세·깊이 같은 조건을 반영하도록 학습하는 복사본입니다.
글은 장면의 내용과 분위기를 설명하고, 스케치·구도 자료는 형태와 배치를 더 분명하게 전달합니다.
오늘도 장면을 글로만 설명하기 어려우면, 스케치나 참조 이미지를 함께 준비합니다.
미드저니(Midjourney)는 글과 참조 이미지를 바탕으로 새 이미지를 생성하는 AI 서비스다.
이미지를 만들고, 스타일을 조절하고, 선택한 결과를 변형·편집할 수 있다.
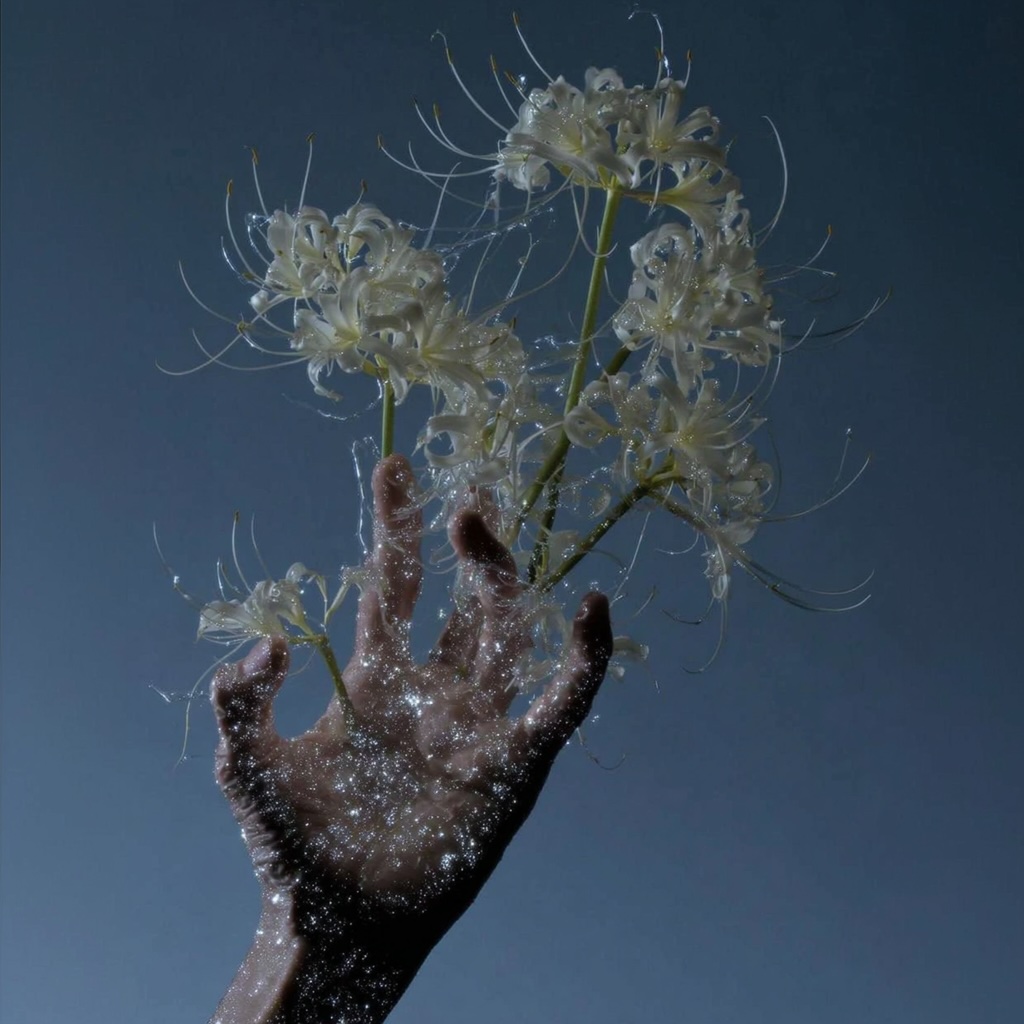
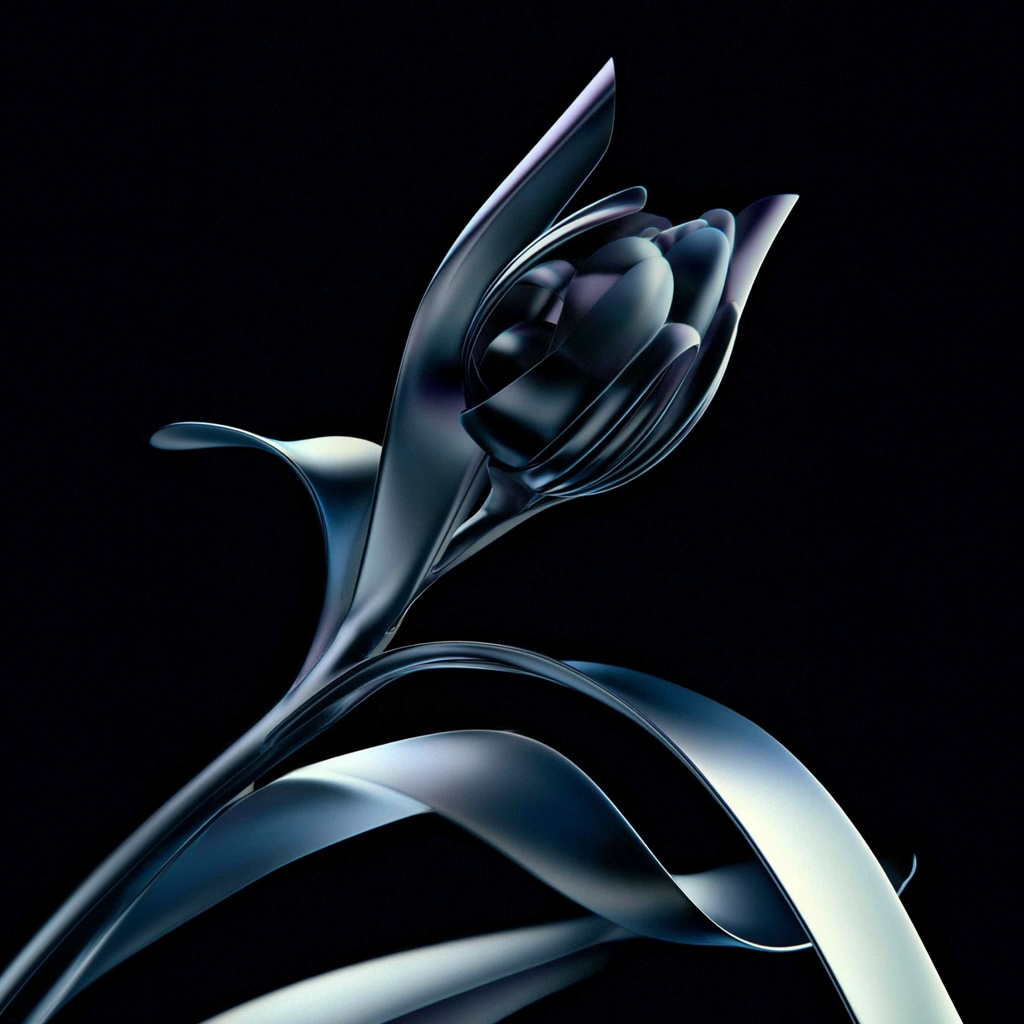
대상·공간·빛·재료를 문장으로 설명하면, 그 조건을 바탕으로 시각적인 결과를 만든다.
비율과 스타일을 바꾸고, 참조 이미지로 구도·색·질감의 방향을 줄 수 있다.
후보를 비교하고 변형·편집한다. 작품의 주제와 맞는지 판단하고 선택하는 일은 내가 한다.
수업에서의 활용: Gemini로 정리한 주제 → 장면을 글로 작성 → Midjourney로 이미지 실험
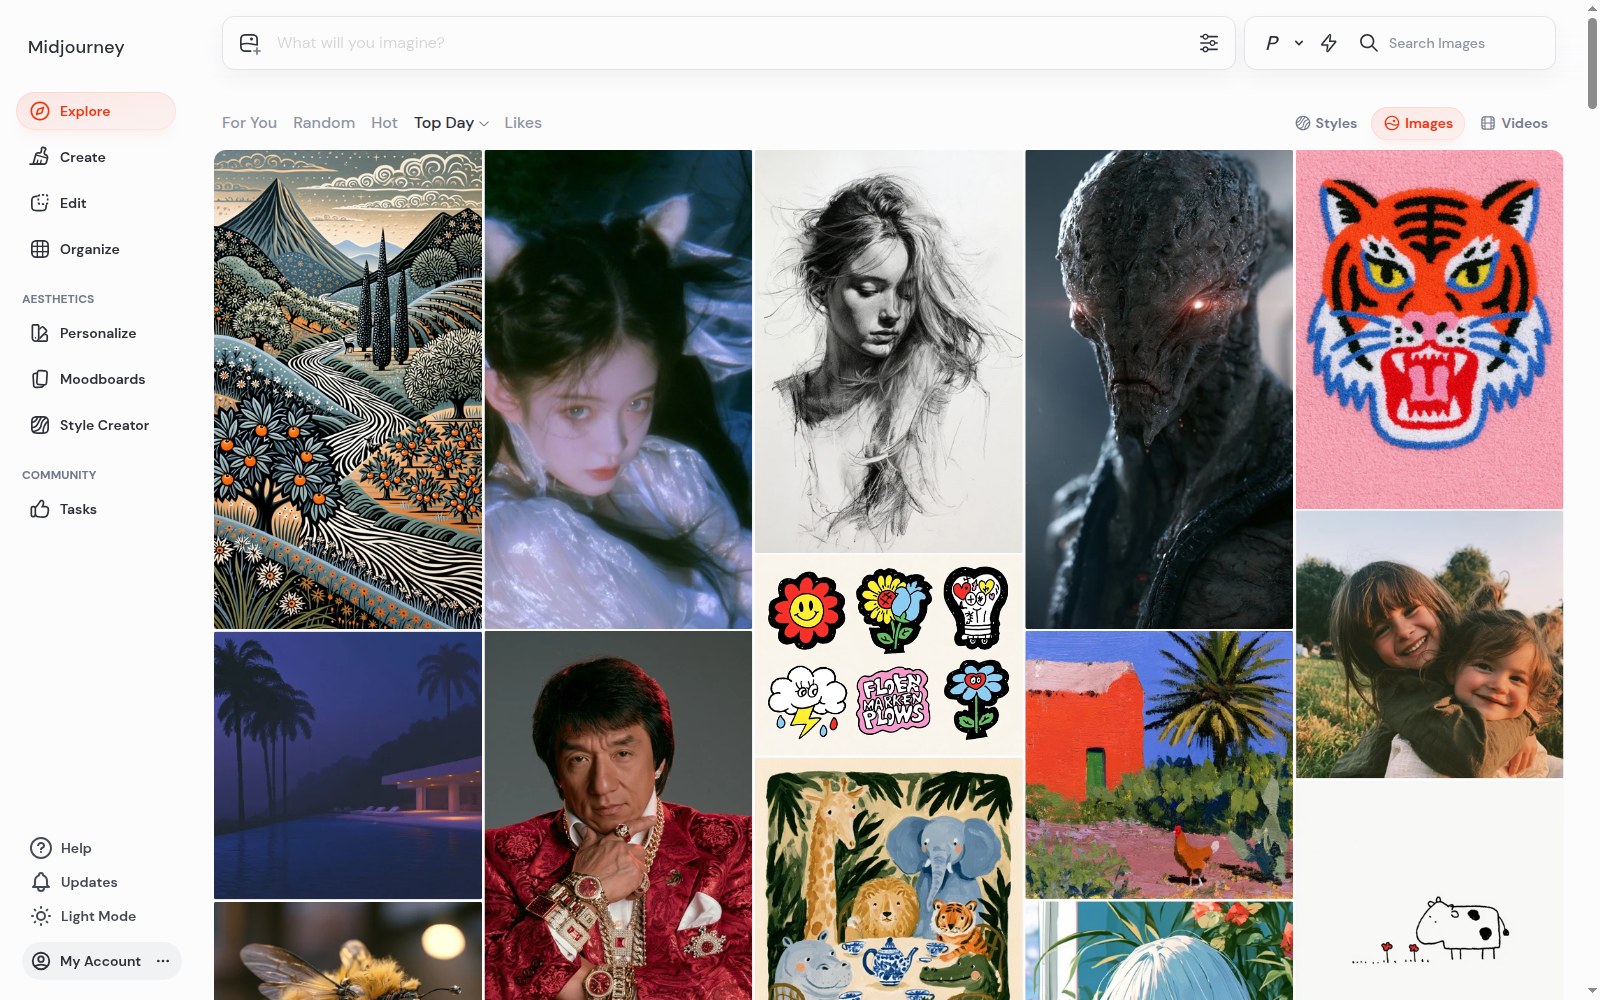
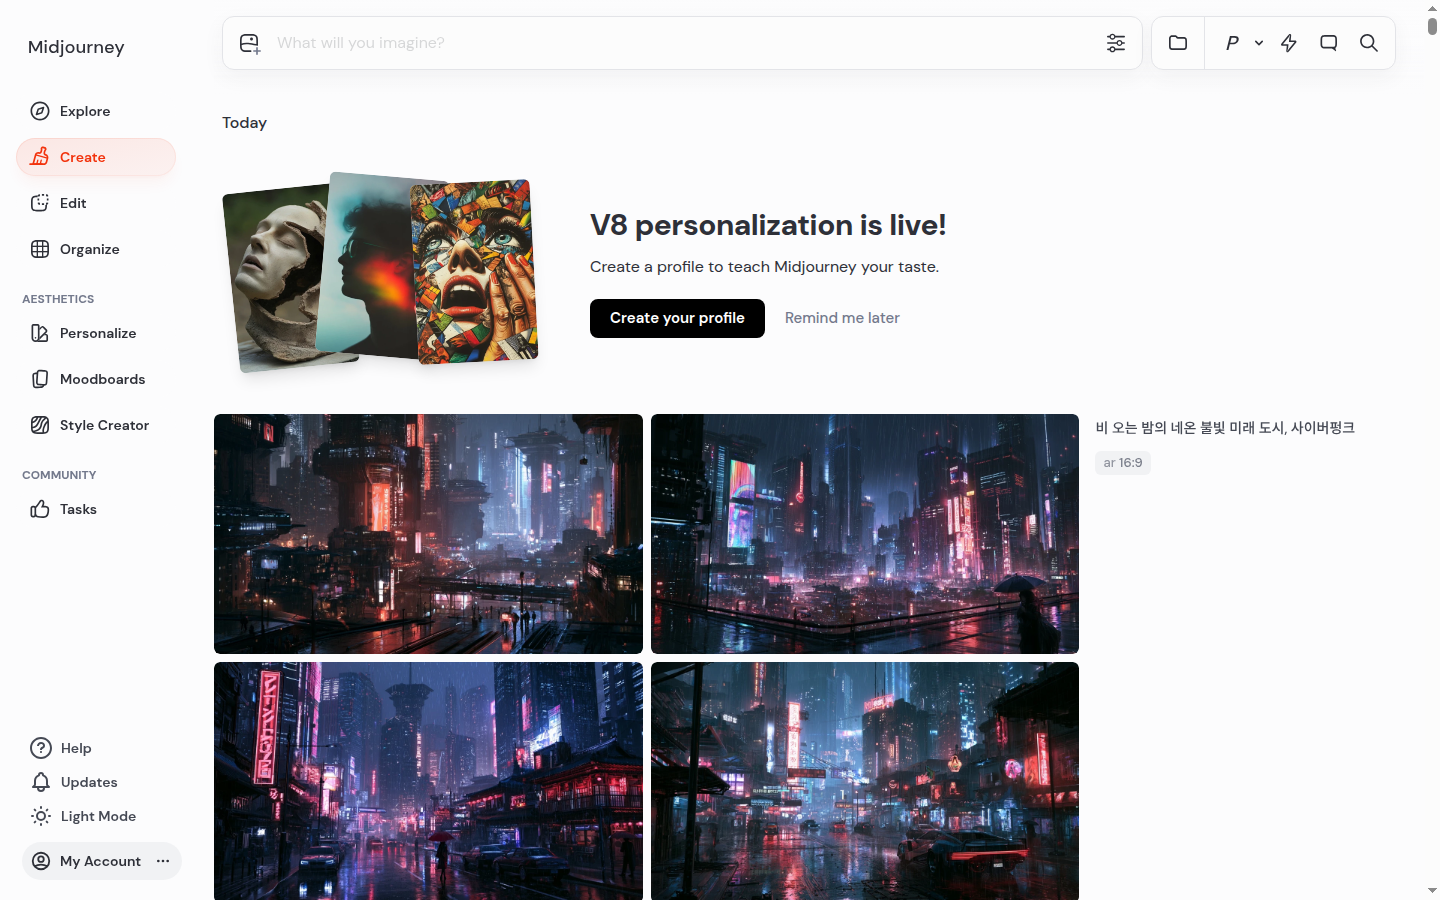

대상·공간·빛·재료처럼 화면에 보일 내용을 한글로 쓴다. 웹에서는 /imagine을 붙일 필요가 없다.
이미지 아이콘에서 자료를 넣는다. 첫 생성에서는 비워 두고, 이미지 참조는 3교시에 배운다.
설정 아이콘은 생성 방식, P/프로필은 취향 반영에 관계한다. 비교 실험을 할 때 적용 상태를 동일하게 유지한다.
원하는 것을 명확하게 묘사한다. 무조건 짧게 줄이기보다 중요한 조건을 남기고, 반복되는 수식어와 충돌하는 지시를 덜어 낸다.
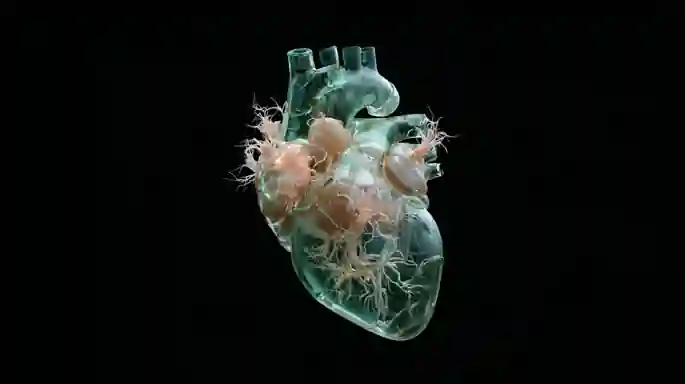
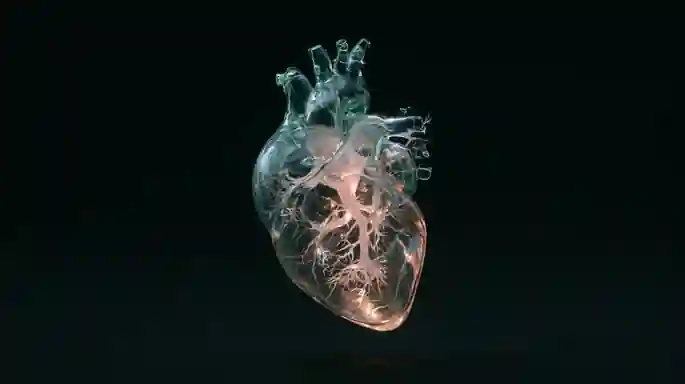
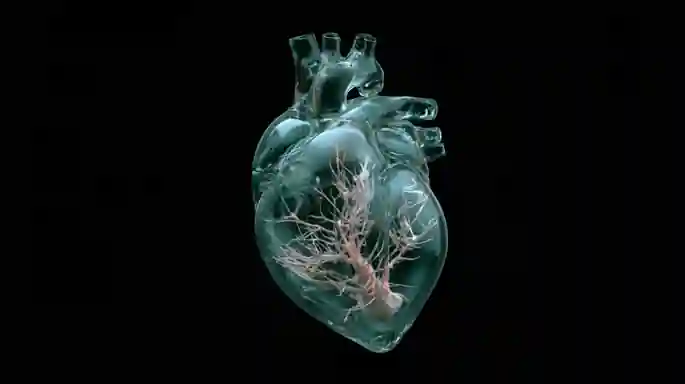
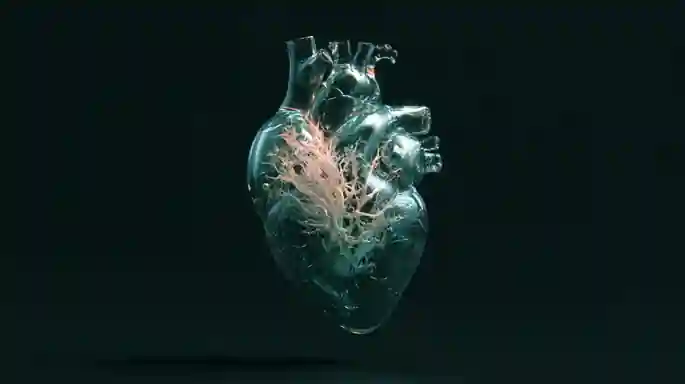
유리 심장·흰 뿌리·청록과 호박색이라는 조건은 같아도 모양과 빛의 배치가 달라진다.
표준 생성은 한 번에 네 후보를 제시한다. 문장이 같아도 생성 과정의 무작위성 때문에 형태와 배치가 달라질 수 있다. 네 장은 정답 네 개가 아니라 비교할 선택지다.
빛나는 가닥과 관람 동선이 반영됐다. 실제 재료와 시공 방식은 정해지지 않았다.
흰 미술관 전시장 바닥에서 가느다란 광섬유 수천 가닥이 풀처럼 자란다, 끝부분만 은은하게 푸른빛으로 빛난다, 관객이 걸어갈 수 있는 구불구불한 길, 낮은 눈높이에서 본 전경, 생태와 기술의 관계를 다루는 설치미술 구상 --ar 16:9
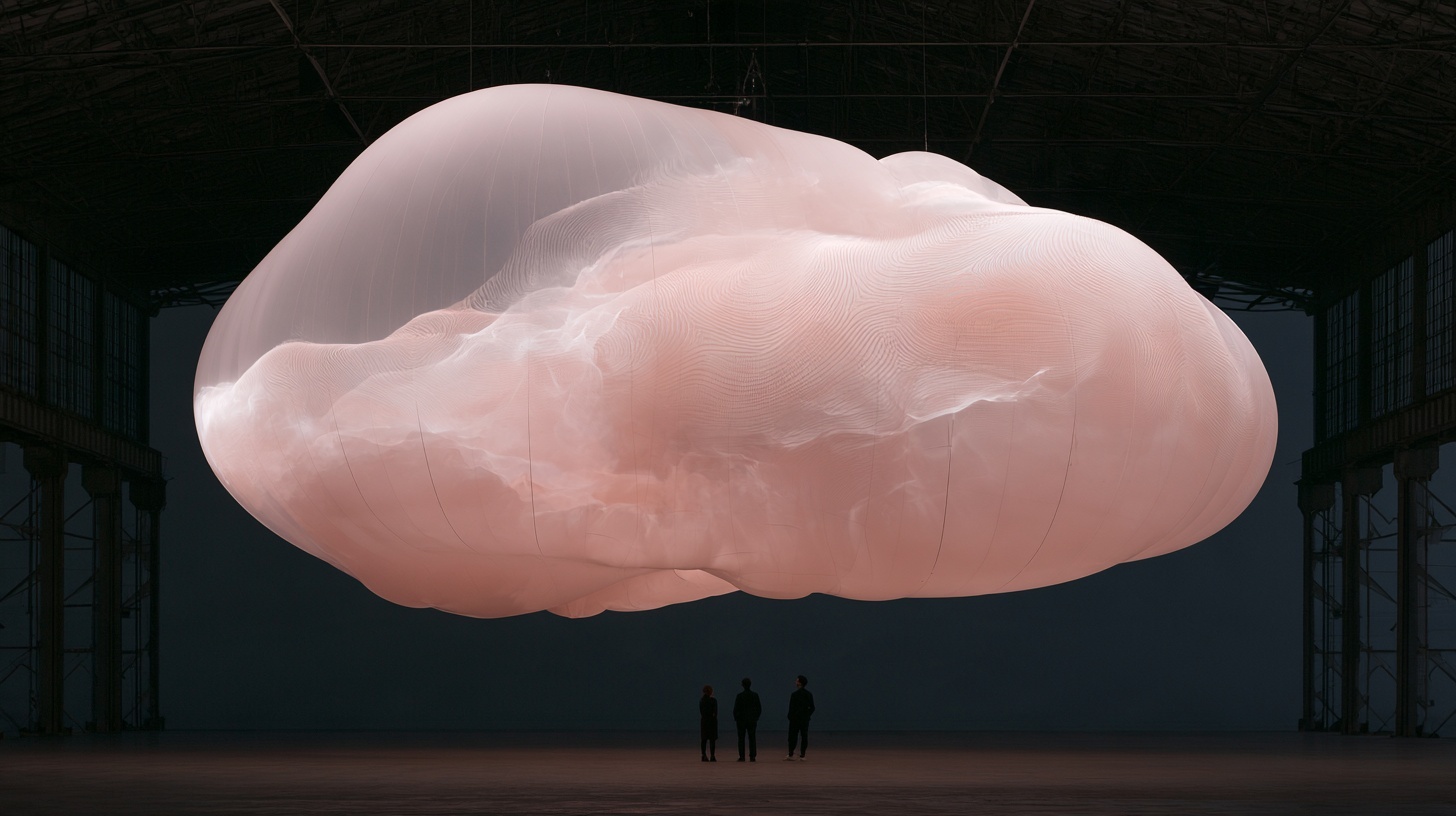
작은 관객 세 명이 거대한 조형물의 크기를 보여 준다. 호흡은 아직 정지 이미지의 구상이다.
어두운 산업 창고 한가운데 천장에 매달린 거대한 반투명 풍선, 표면에 사람의 지문 같은 유기적인 선들이 투사된다, 풍선 아래 아주 작은 관객 세 명, 부드러운 호박색 빛, 신체의 호흡을 상상하게 하는 미디어아트 설치 전경 --ar 16:9
2026.09.26 생성 · 개인화 q311u7t 적용 · 이미지를 누르면 원문과 후보 4장을 볼 수 있다. 전시장 이미지는 실제 전시 기록이 아닌 구상 이미지다.
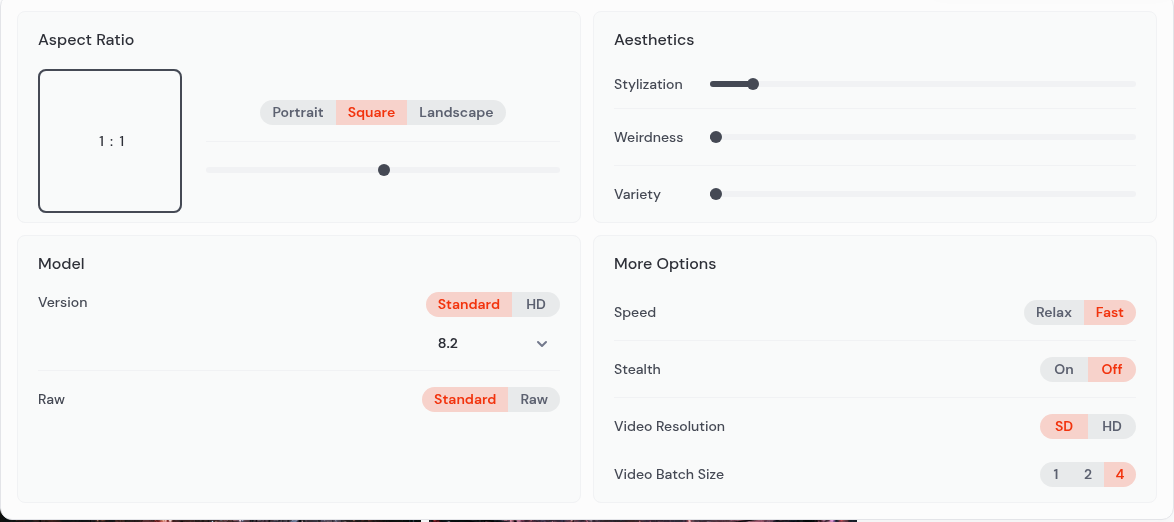
| 항목 | 내용 |
|---|---|
| Aspect Ratio | 가로세로 비율. 영상용 장면은 16:9, 포스터는 3:4. 프롬프트 뒤에 --ar 16:9로 써도 같다. |
| Stylization | 미드저니 특유의 미감을 얼마나 얹을지. 기본값에서 시작한다. |
| Weirdness · Variety | 이상함의 정도 · 4장의 다양성. 탐색이 막힐 때 올려 본다. |
| Model · Raw | 버전 8.2 기본. HD는 2048px 고해상도로 시간이 더 든다 — 탐색은 Standard, 최종본만 HD. Raw는 미감 개입을 줄인다. |
| Speed | Fast가 기본. Basic 요금제는 Fast 시간만 있다 — 남은 시간을 설정에서 확인한다. |
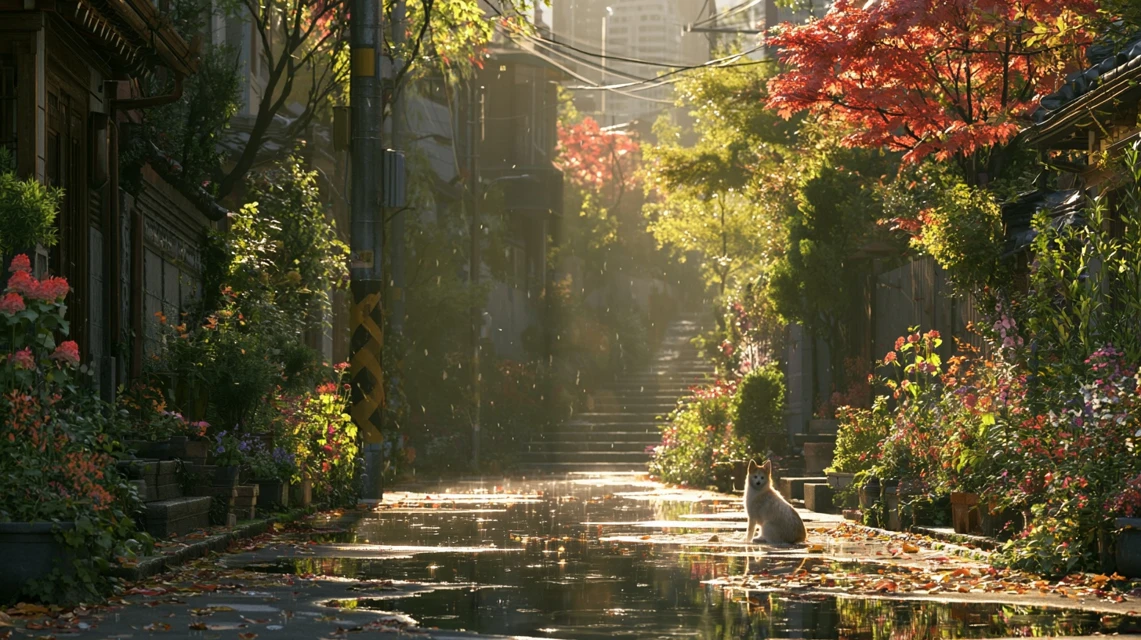
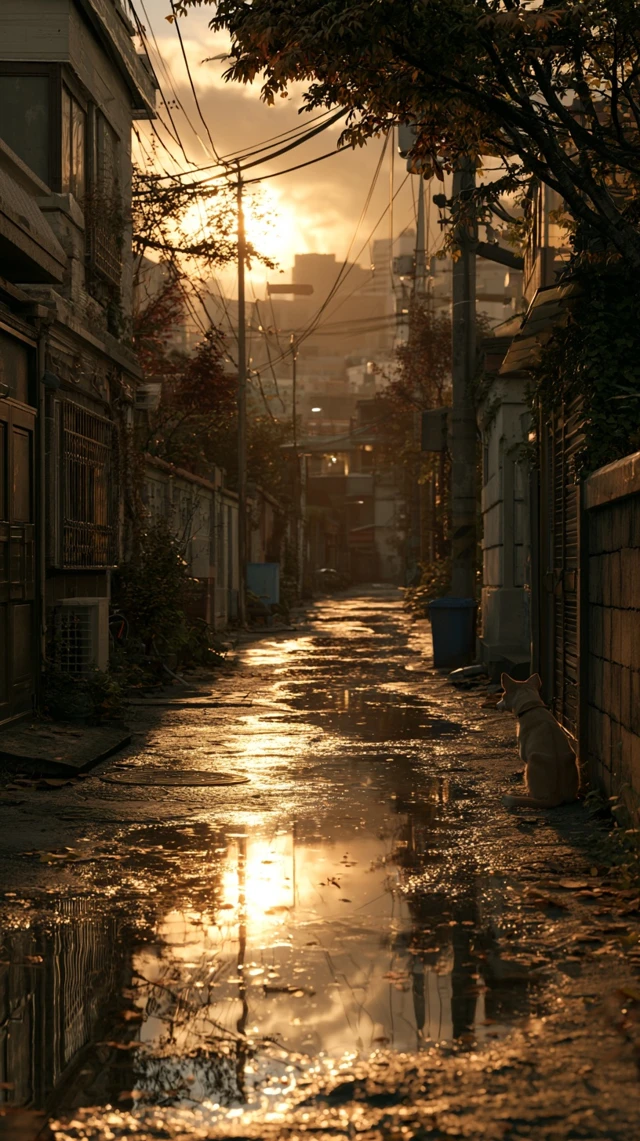
프롬프트에 "~없이", "~는 넣지 마"라고 쓰면 오히려 그 단어가 이미지에 나타난다. 자연어로 쓴 부정은 기대대로 반영되지 않을 수 있다. 제외는 프롬프트 끝에 --no로 적는다.
수채화
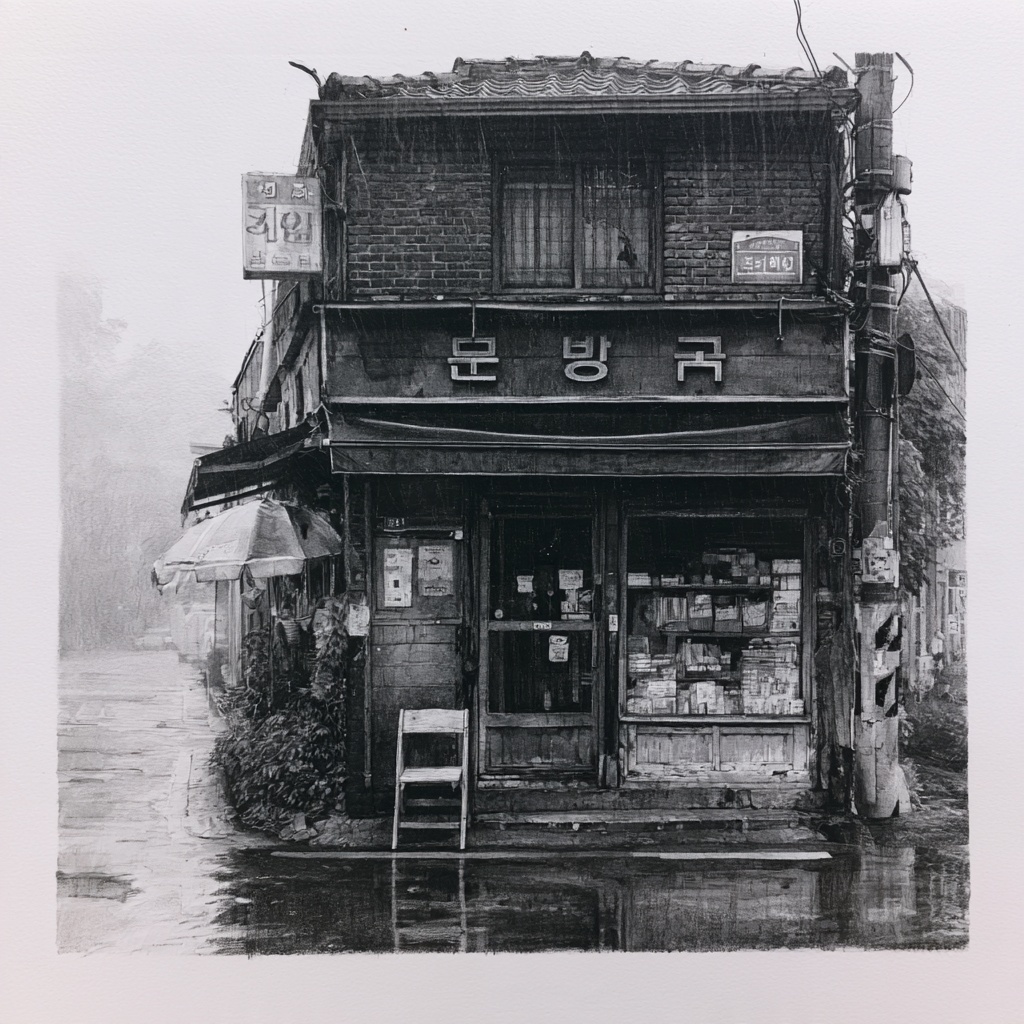
목탄
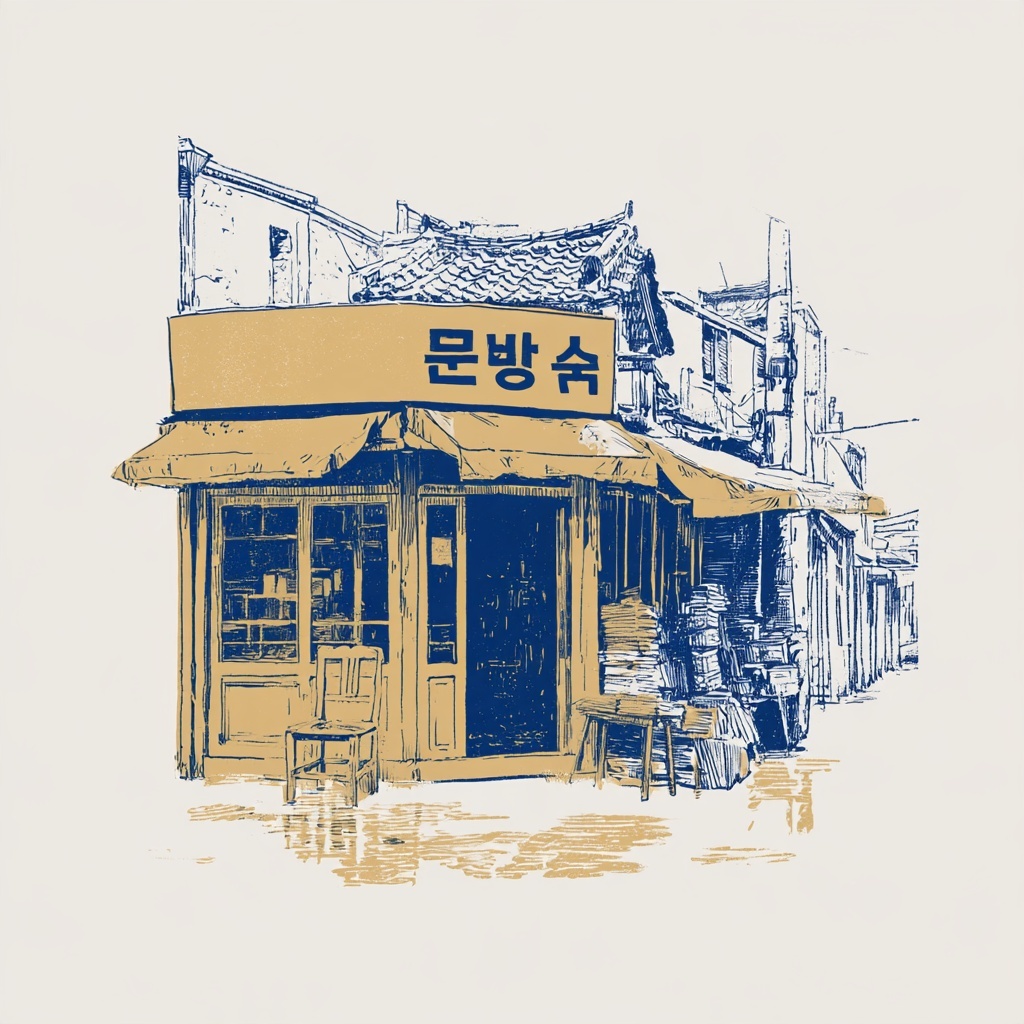
목판화
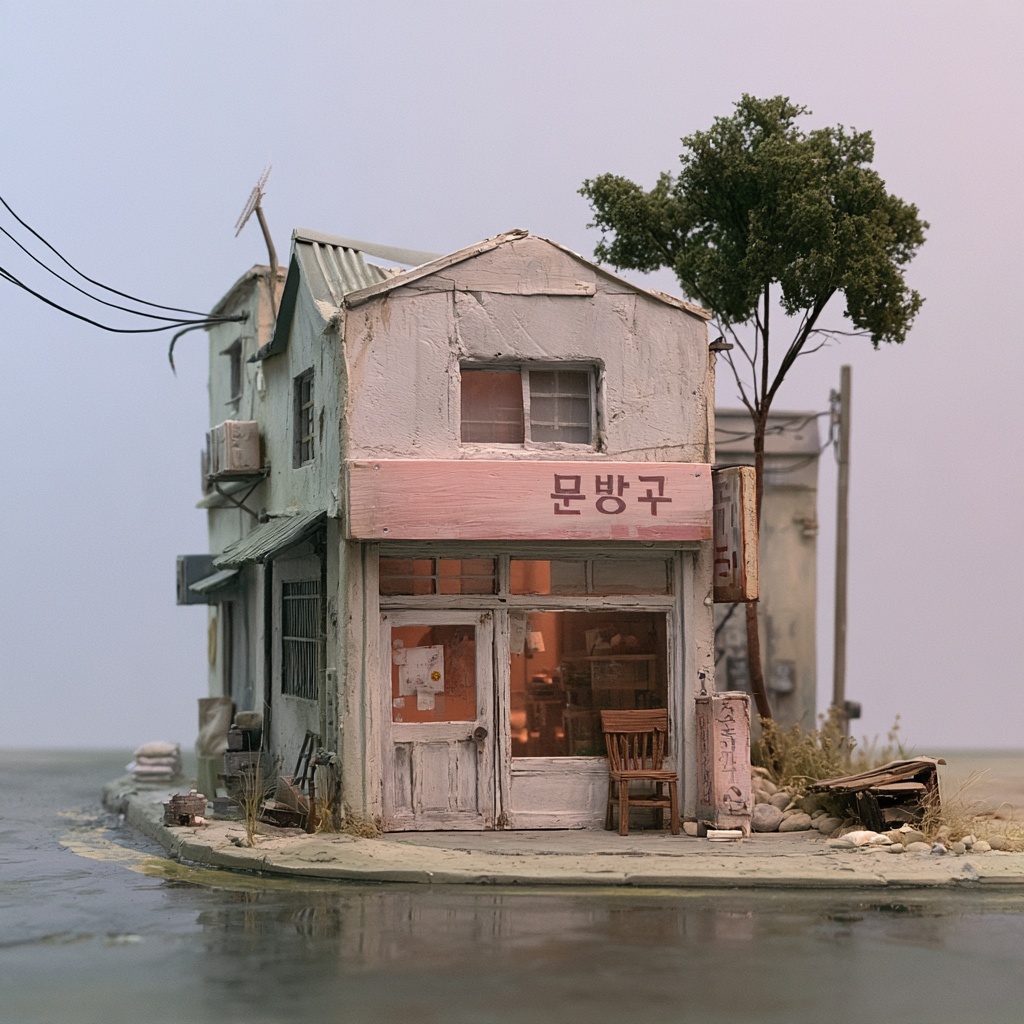
미니어처
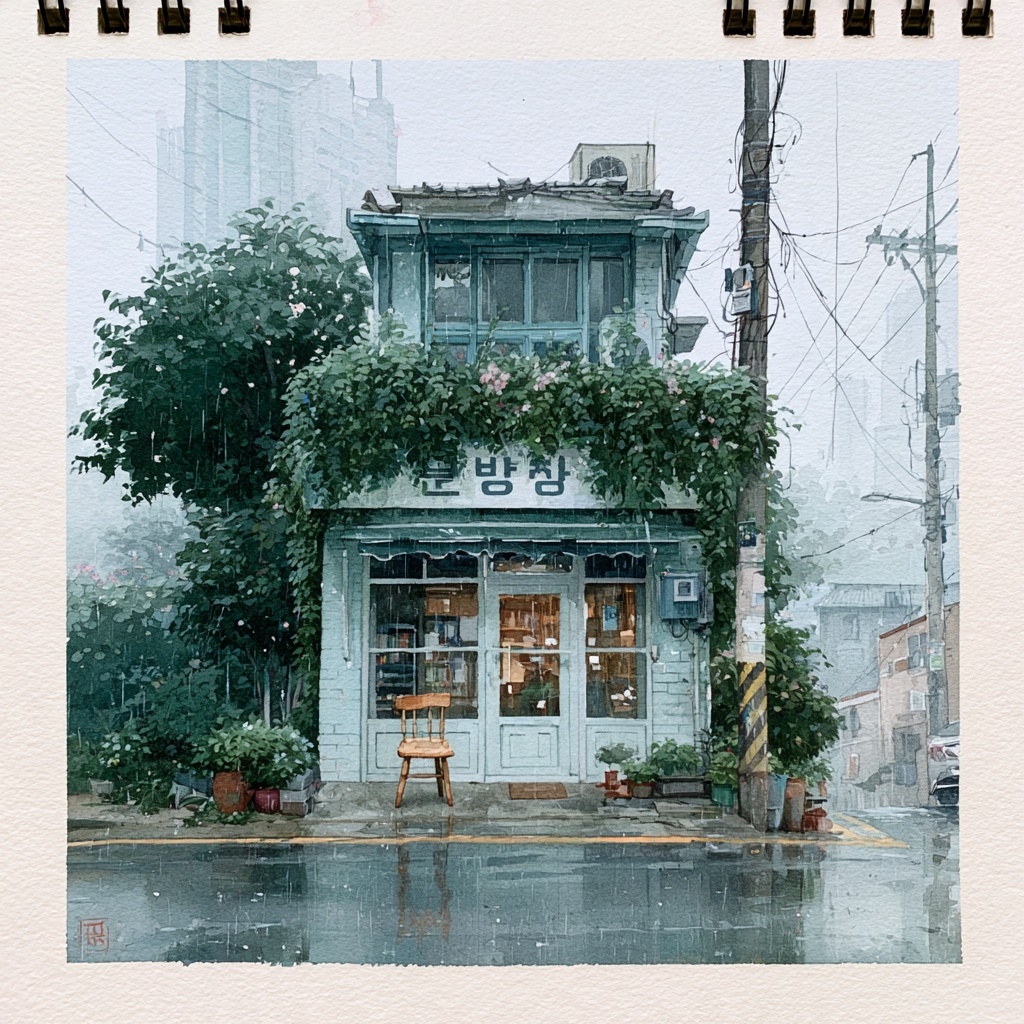
수채화 → 번짐과 종이의 여백
목탄 → 검게 문지른 면과 지워 낸 빛
목판화 → 제한된 색면과 칼자국
미니어처 → 작은 모형의 표면과 얕은 심도
다음 사례는 같은 장면 묘사에 매체의 특징을 바꿔 넣은 실제 결과다. 색과 재료뿐 아니라 건물·구도도 달라졌는지 비교한다.
종이 질감과 옅은 청록색이 보인다. 간판 글자는 정확하지 않다.
닫힌 오래된 동네 문방구, 문 앞의 빈 나무 의자 하나, 비가 그친 젖은 골목, 정면 구도, 투명한 수채화, 크림색 수채화 종이, 번지는 가장자리, 옅은 청록색과 황토색 --ar 1:1
흑백 명암과 문지른 질감이 보인다. 같은 문장이어도 건물은 달라졌다.
닫힌 오래된 동네 문방구, 문 앞의 빈 나무 의자 하나, 비가 그친 젖은 골목, 정면 구도, 흑백 목탄 드로잉, 거친 종이, 검게 문지른 면과 지우개로 지워 낸 빛, 강한 명암 --ar 1:1
2026.09.26 생성 · 개인화 q311u7t 적용 · 이미지를 누르면 원문과 후보 4장을 볼 수 있다. 전시장 이미지는 실제 전시 기록이 아닌 구상 이미지다.
남색·황토색의 제한된 색면이 반영됐다. 정면 지시는 비스듬한 시점으로 변했다.
닫힌 오래된 동네 문방구, 문 앞의 빈 나무 의자 하나, 비가 그친 젖은 골목, 정면 구도, 남색과 황토색 두 가지 잉크의 목판화, 굵은 칼자국, 단순한 색면, 선명한 윤곽 --ar 1:1
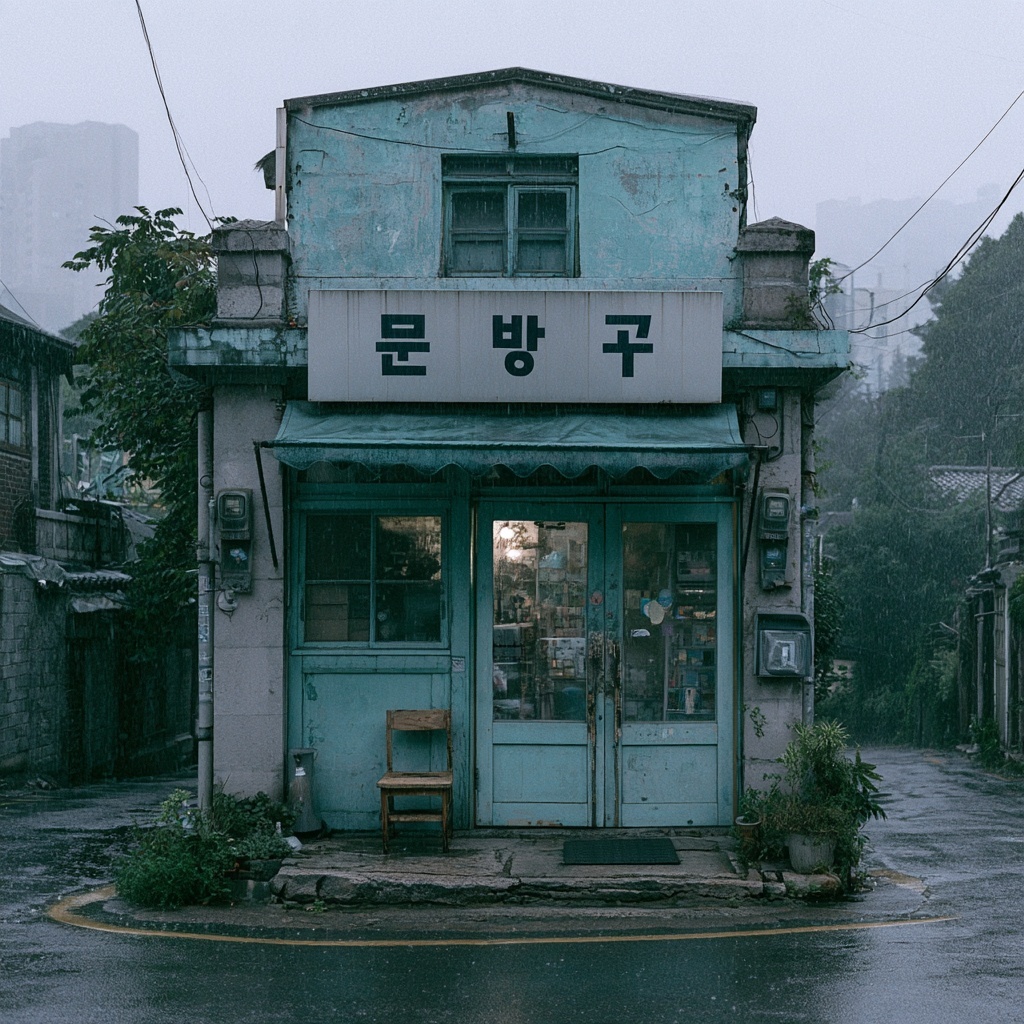
바랜 색과 흐린 빛이 반영됐다. 실제 장소를 촬영한 사진은 아니다.
닫힌 오래된 동네 문방구, 문 앞의 빈 나무 의자 하나, 비가 그친 젖은 골목, 정면 구도, 35밀리미터 필름 사진, 흐린 오후의 부드러운 빛, 바랜 청록색과 회색, 미세한 필름 입자 --ar 1:1
2026.09.26 생성 · 개인화 q311u7t 적용 · 이미지를 누르면 원문과 후보 4장을 볼 수 있다. 전시장 이미지는 실제 전시 기록이 아닌 구상 이미지다.
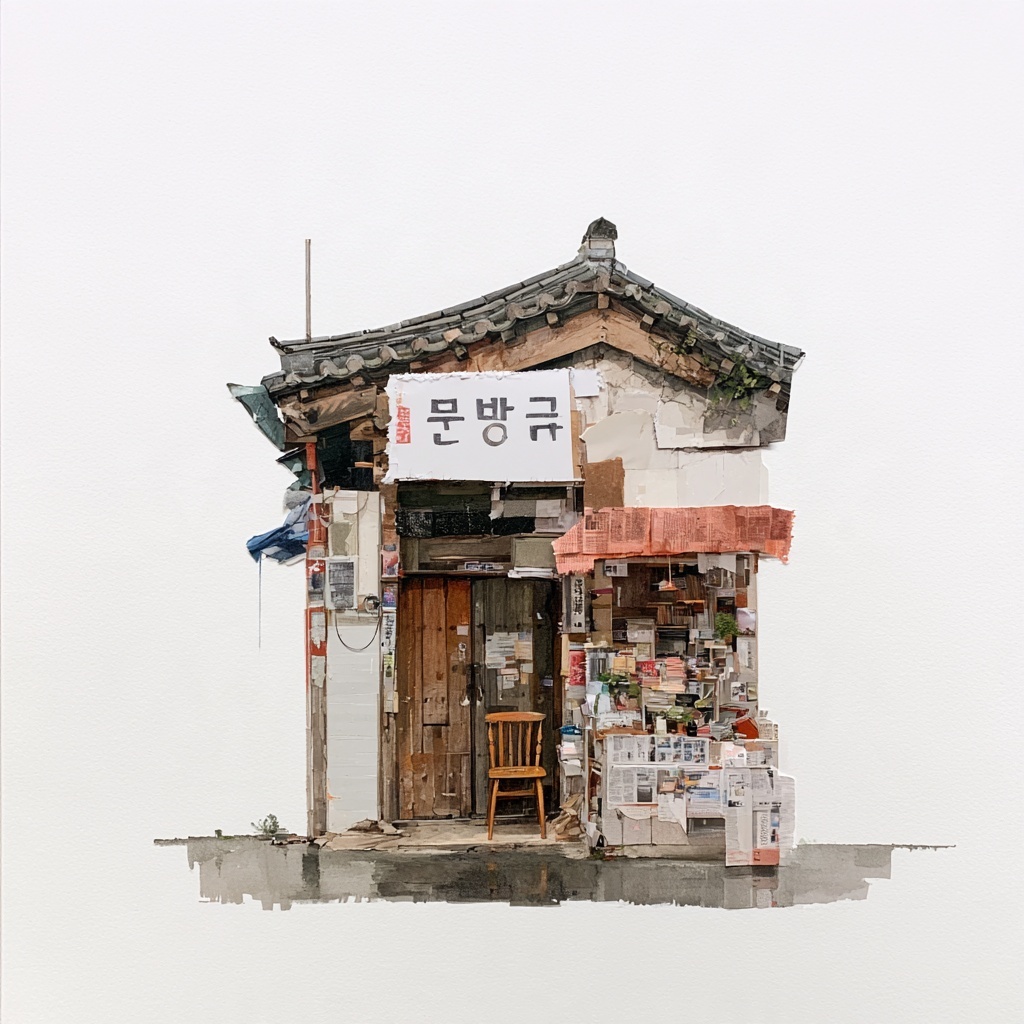
종이 조각과 겹친 가장자리가 드러난다. 골목 배경은 크게 줄었다.
닫힌 오래된 동네 문방구, 문 앞의 빈 나무 의자 하나, 비가 그친 젖은 골목, 정면 구도, 손으로 자른 종이 콜라주, 겹친 종이의 가장자리, 인쇄물 조각, 평평하게 단순화한 형태 --ar 1:1
모형 같은 표면과 작은 공간감이 나타난다. 매체를 바꾸면 구조도 변한다.
닫힌 오래된 동네 문방구, 문 앞의 빈 나무 의자 하나, 비가 그친 젖은 골목, 정면 구도, 손으로 만든 미니어처 디오라마 사진, 골판지 건물과 작은 의자, 점토 질감, 얕은 심도 --ar 1:1
2026.09.26 생성 · 개인화 q311u7t 적용 · 이미지를 누르면 원문과 후보 4장을 볼 수 있다. 전시장 이미지는 실제 전시 기록이 아닌 구상 이미지다.
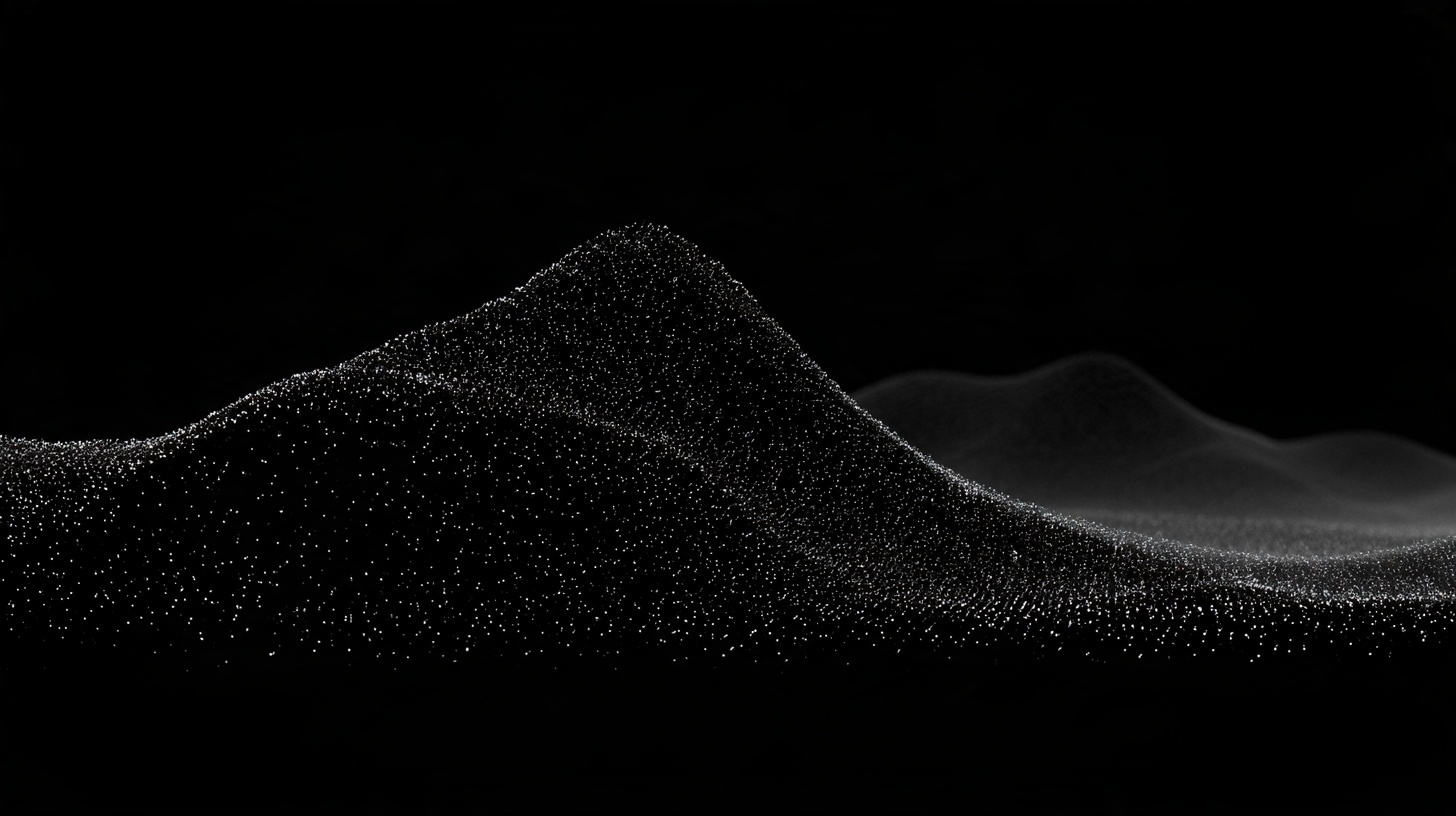
작은 점과 깊이감이 반영됐다. 데이터 기반 작품의 구상 이미지로 활용할 수 있다.
검은 화면을 가득 채우는 수만 개의 작은 흰 점, 점들이 거대한 파도처럼 겹쳐진 곡면을 이룬다, 앞쪽은 또렷하고 먼 곳은 안개처럼 흐려진다, 흑백 생성예술, 깊은 공간감, 가로로 긴 파노라마, 데이터 흐름을 표현한 추상 이미지 --ar 16:9
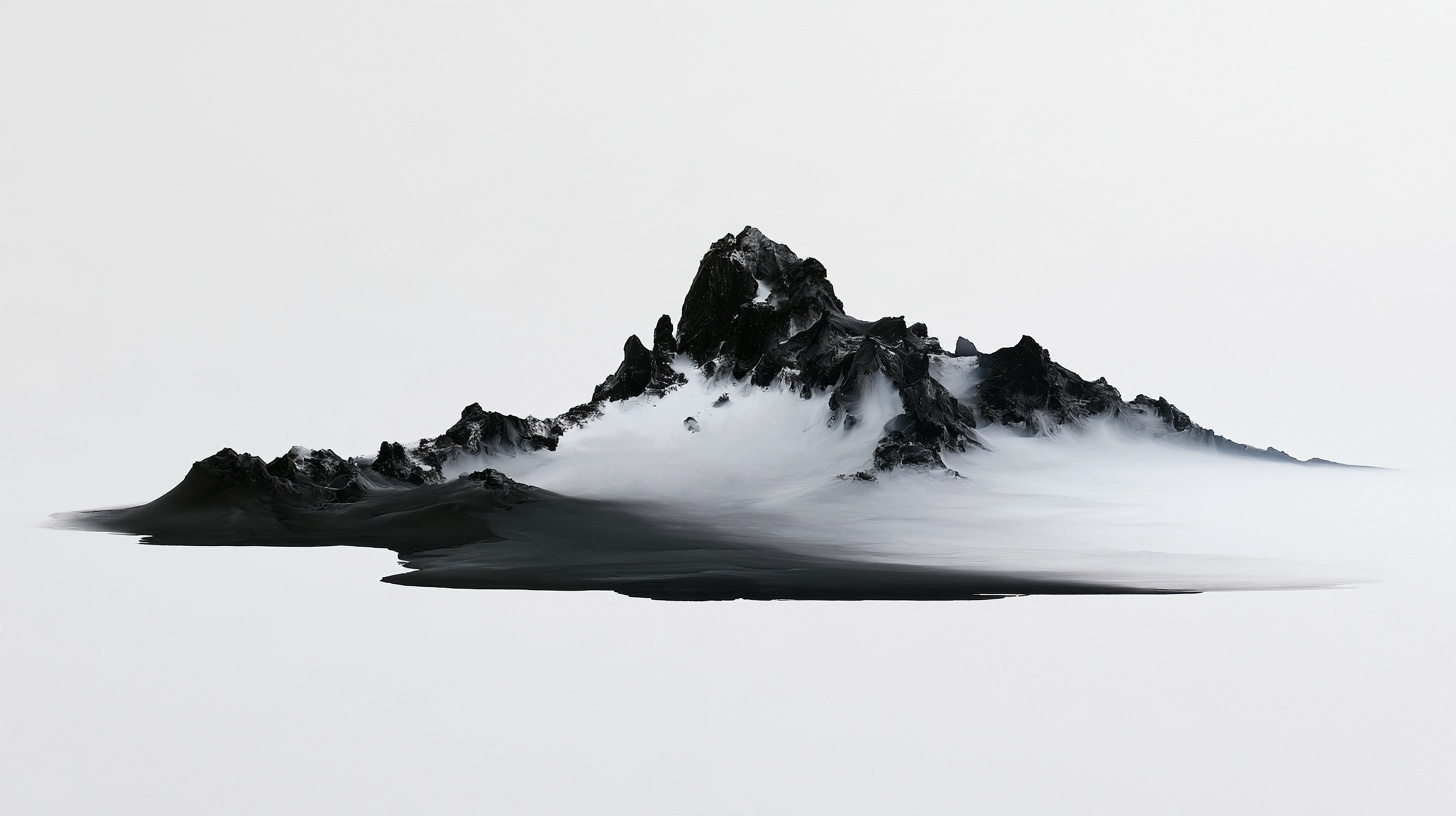
검정·회색·여백은 반영됐다. 위에서 본 평면보다 입체 산맥에 가깝다.
흰 종이 위에 번지는 검은 먹이 거대한 산맥처럼 보이는 추상 풍경, 짙은 먹의 가장자리와 섬세한 회색 번짐, 넓은 흰 여백, 위에서 내려다본 지형 같은 구도, 동양 수묵의 물성과 위성사진의 시점을 결합한 이미지 --ar 16:9
2026.09.26 생성 · 개인화 q311u7t 적용 · 이미지를 누르면 원문과 후보 4장을 볼 수 있다. 전시장 이미지는 실제 전시 기록이 아닌 구상 이미지다.
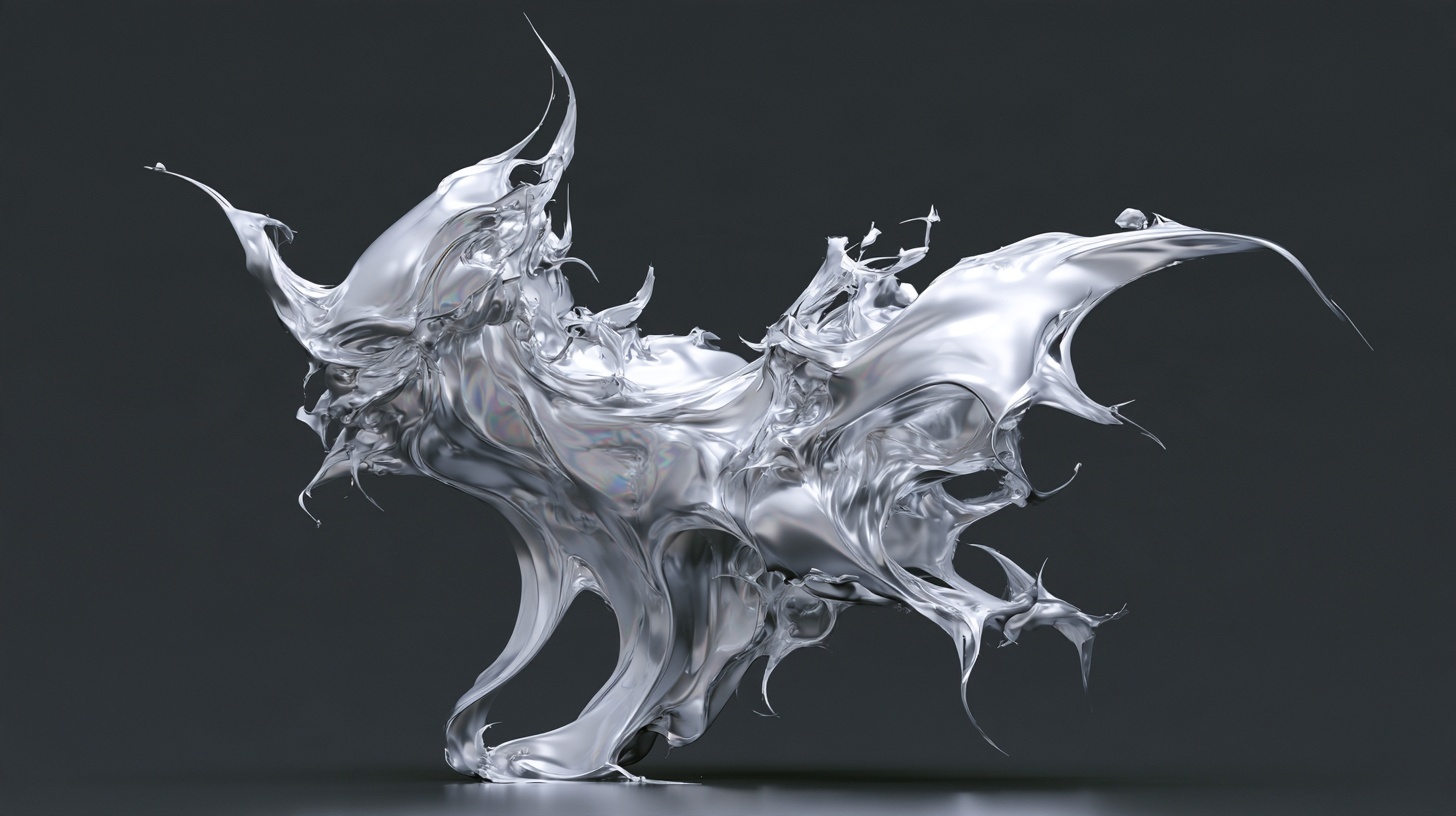
금속 반사와 날카로운 곡면이 반영됐다. 리본보다 덩어리 조각에 가깝다.
검은 공간에서 서로 얽히는 은색 액체 금속 리본, 물결처럼 접힌 표면, 미세한 무지갯빛 반사, 날카로운 윤곽과 부드러운 곡선의 대비, 한쪽에서 들어오는 흰 스튜디오 조명, 초현실적 디지털 조각, 화면 중앙을 가로지르는 역동적 구도 --ar 16:9
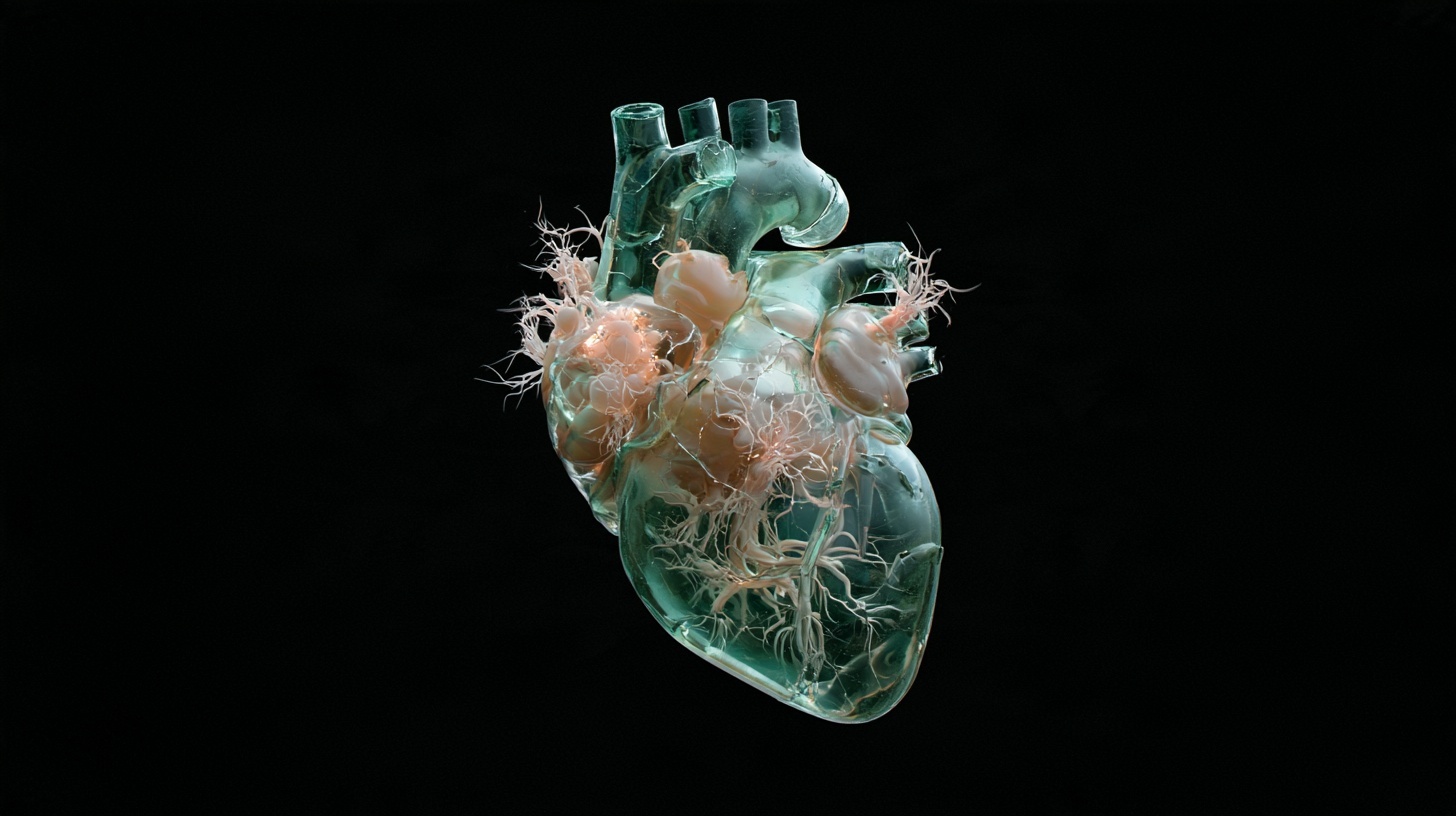
투명한 유리와 뿌리, 두 색의 대비가 반영됐다. 작은 균열은 두드러지지 않는다.
검은 배경 한가운데 떠 있는 반투명 유리 심장, 심장 안에서 가느다란 흰 뿌리들이 가지를 뻗으며 빛난다, 생명과 인공물의 경계, 유리 표면의 미세한 균열, 차가운 청록색과 따뜻한 호박색의 대비, 극적인 측면 조명, 여백이 넓은 중앙 구도, 미디어아트 영상에 사용할 초현실적인 조형 이미지 --ar 16:9
2026.09.26 생성 · 개인화 q311u7t 적용 · 이미지를 누르면 원문과 후보 4장을 볼 수 있다. 전시장 이미지는 실제 전시 기록이 아닌 구상 이미지다.
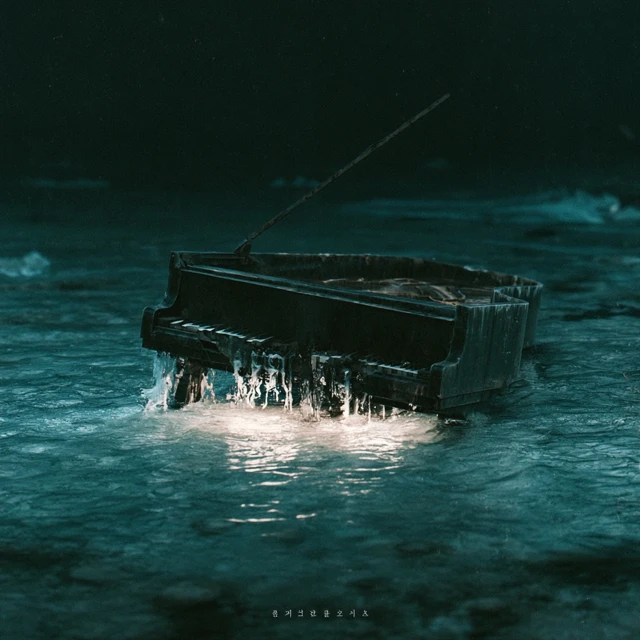
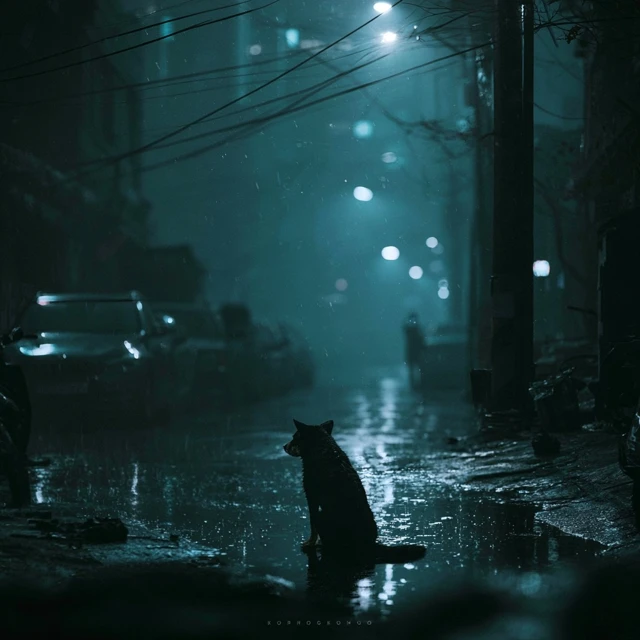
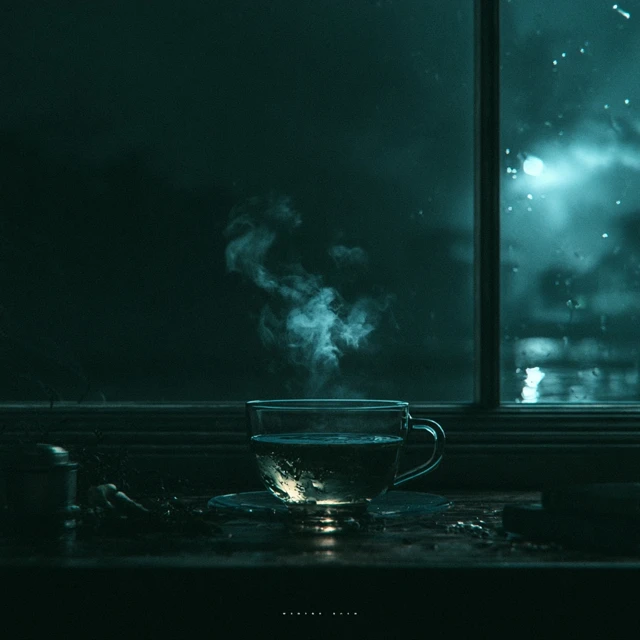
스타일 코드 — 미드저니 안에는 번호가 붙은 스타일 라이브러리가 있다. --sref 1234567890처럼 코드로 부른다. 코드 여러 개를 섞을 수도 있다.
--sref random — 무작위 스타일을 하나 뽑는다. 실행되면 실제 코드로 바뀌어 프롬프트에 남는다 — 마음에 들면 그 번호를 계속 쓰면 된다.
Style Explorer — Explore의 Styles 탭에서 코드들을 구경하고 좋아요로 모아 둘 수 있다. 막막할 때 스타일 사전처럼 쓴다.
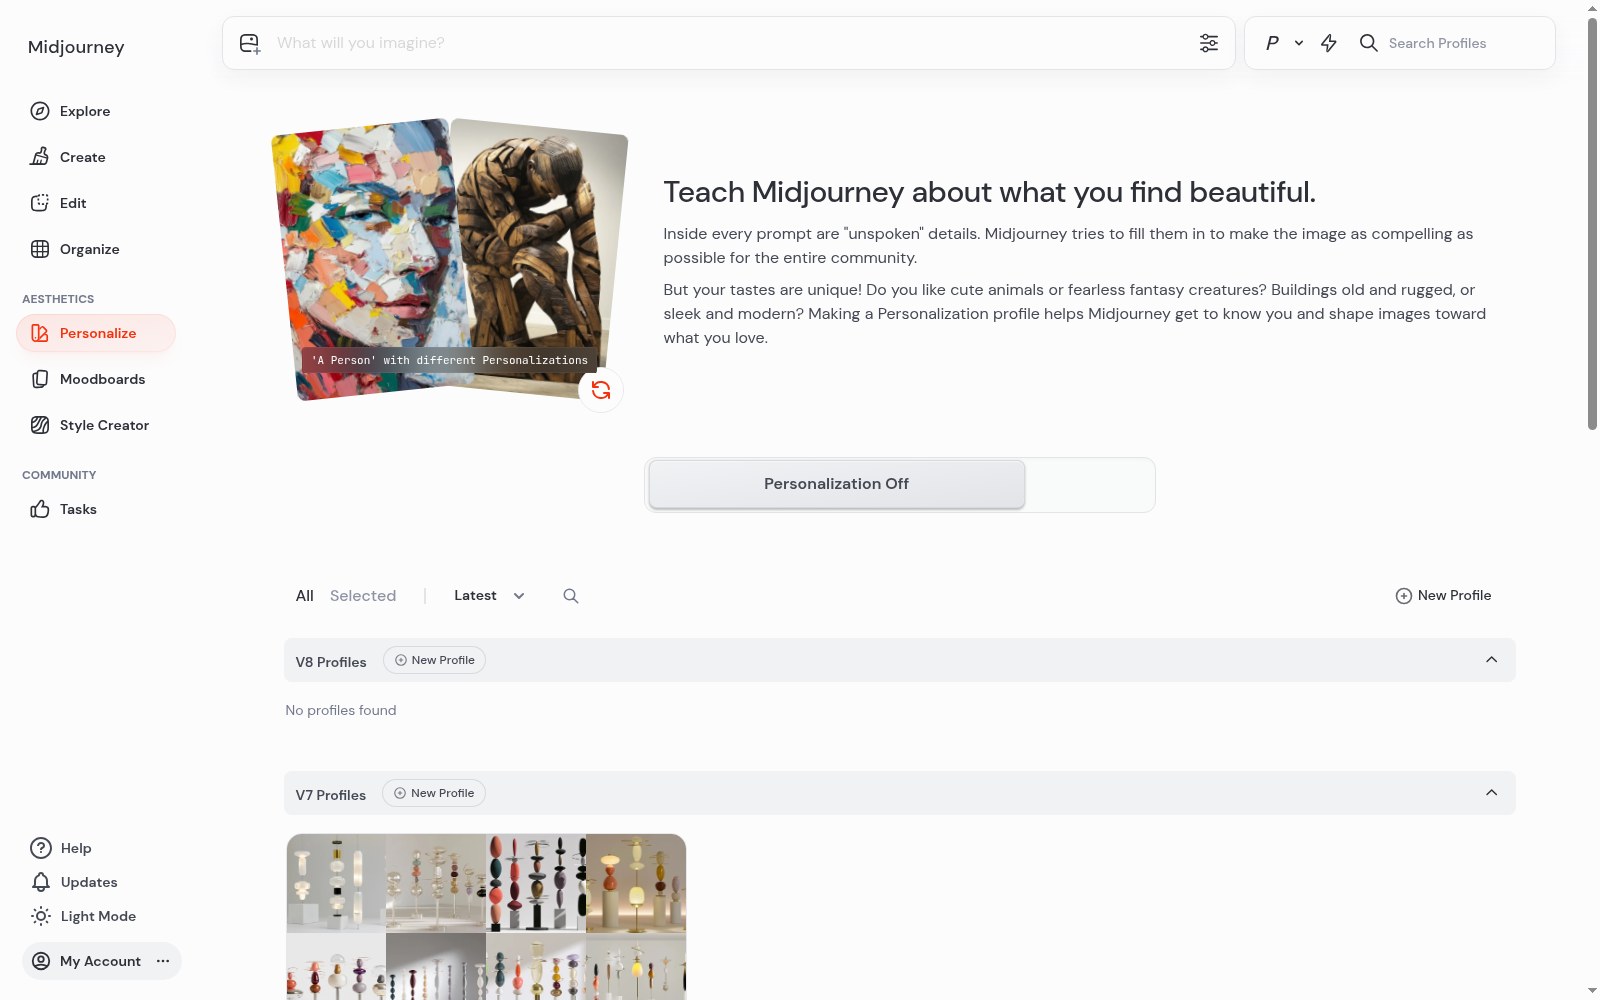
무엇인가 — 이미지 여러 장을 모아 만드는 나만의 스타일. 레퍼런스 한 장(sref)보다 넓은 미학을 담을 때 쓴다.
만들기 — Moodboards에서 New Moodboard → 이미지를 넣는다. 파일 업로드, 이미지 주소, 내 갤러리 세 가지 경로.
적용 — 프롬프트 바 옆 P 버튼을 켜고 무드보드를 고르거나, --p 뒤에 코드를 쓴다. 강도는 --stylize로 조절한다(--sw와는 같이 못 쓴다).
이 수업에서 — 평소 좋아하는 그림·사진 10~20장으로 무드보드를 만들어 두면, 학기 내내 내 미감의 기준점이 된다.
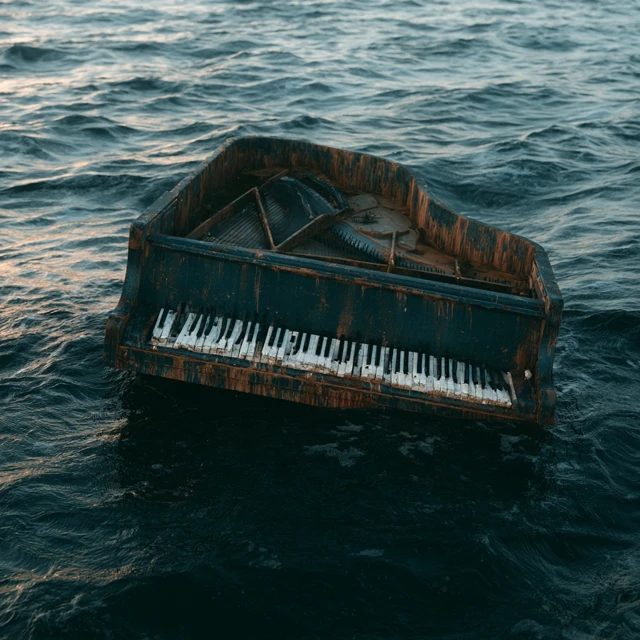
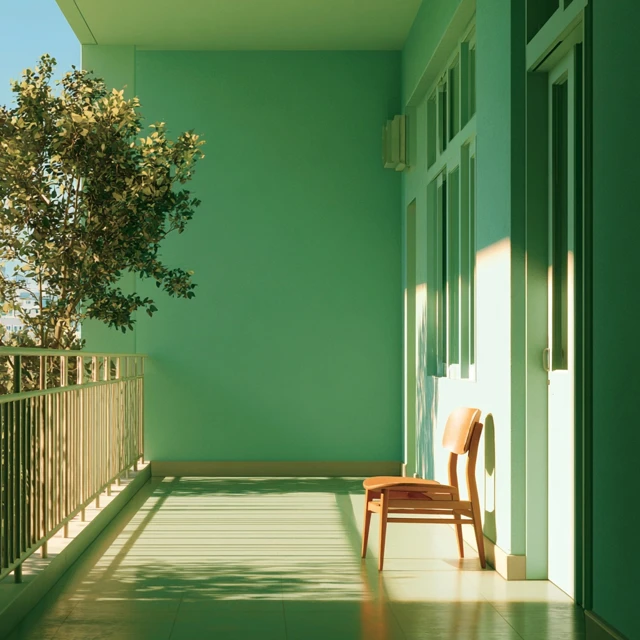
같은 세 장면이다. 위는 각각 다른 스타일로 만들었고, 아래는 같은 스타일 기준을 걸었다.
위쪽은 낱장으로 보면 괜찮지만 나란히 놓으면 한 작품으로 읽히지 않는다. 아래쪽은 소재가 달라도 한 사람의 작업으로 보인다.
오늘 마지막 실습이 이것이다 — 기준 한 장을 정하고, 내 장면 셋에 같은 스타일 레퍼런스를 건다.
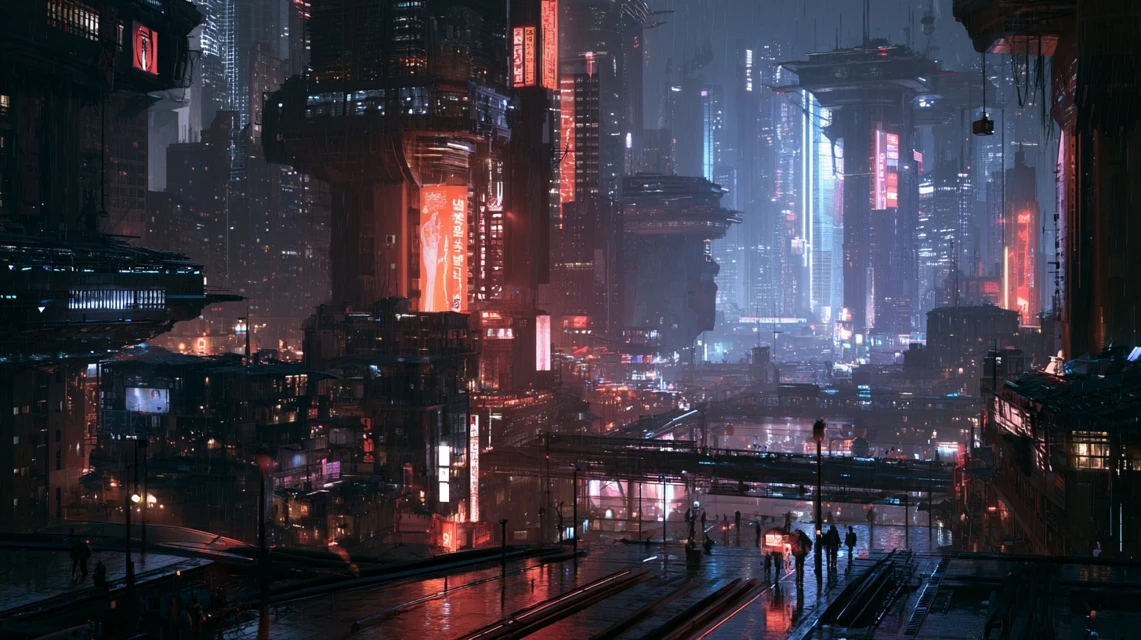
스타일을 안 정하고 뽑다 보면 이런 그림이 자꾸 나온다 — 비 오는 네온 도시, 웅장한 폐허, 몽환적인 소녀. 2주차에 본 익숙한 표현의 반복이 이미지로 나타난 결과다. 학습한 시각적 관습과 기본 미감 때문에 익숙한 표현이 반복될 수 있다.
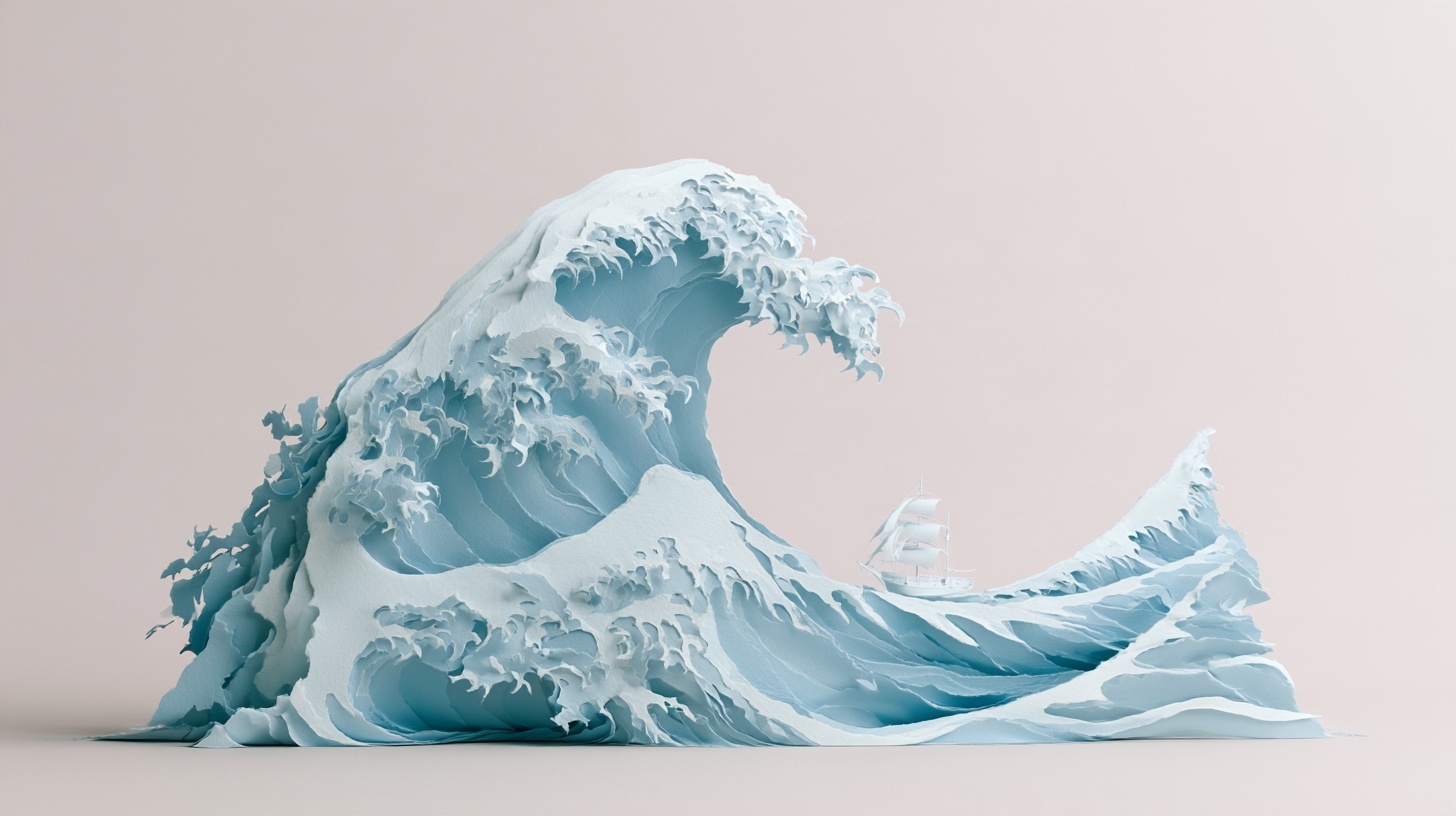
파도의 입체감은 강하다. 종이의 단면은 조각·물결 질감처럼 해석됐다.
파란색과 흰색 종이를 여러 겹 잘라 만든 거대한 파도, 종이의 단면과 손으로 자른 흔적이 선명하다, 파도 가운데 작은 흰 배 한 척, 평면과 입체가 섞인 종이 조형, 부드러운 측면광, 스톱모션 애니메이션의 한 장면 --ar 16:9
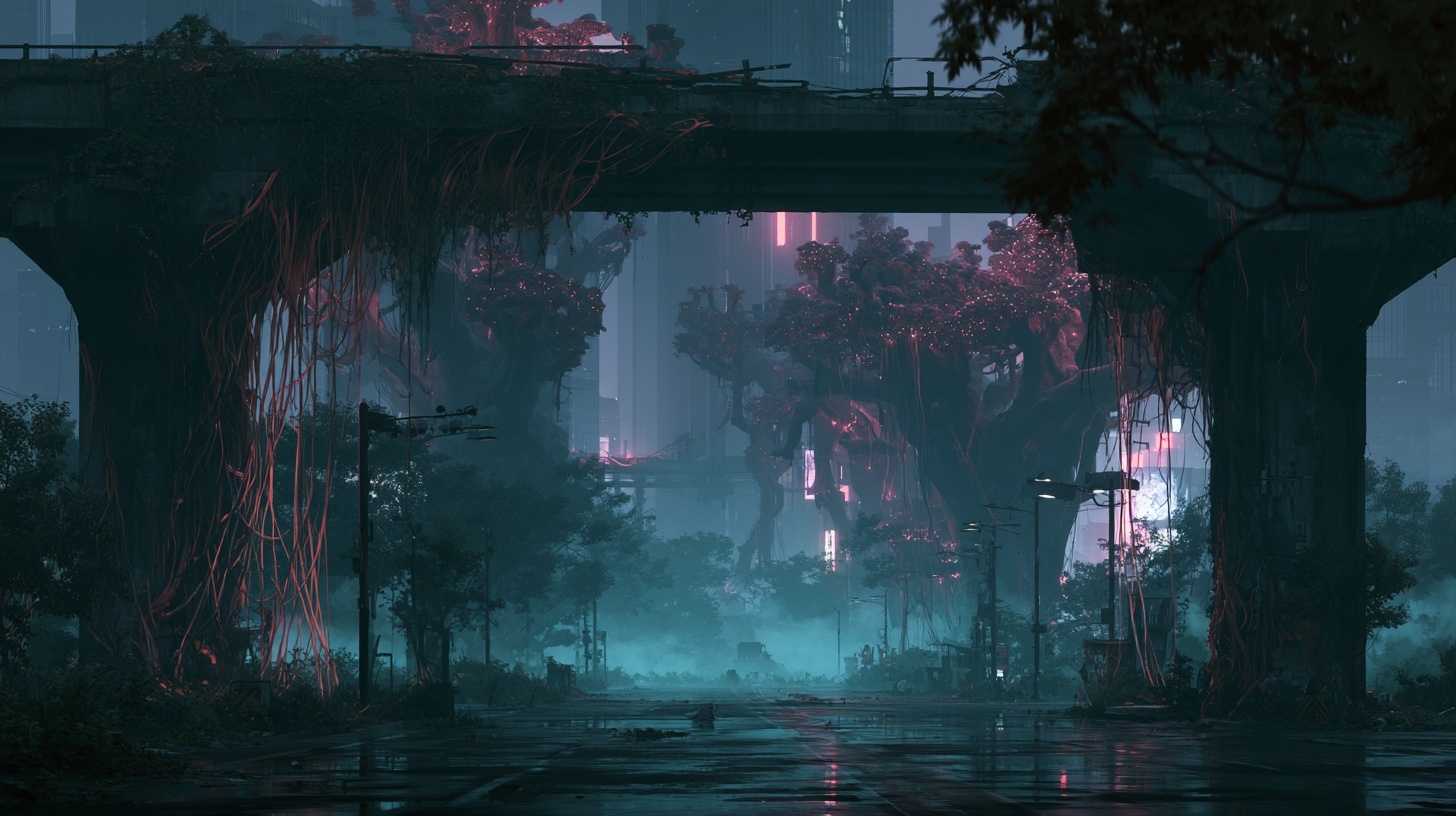
폐허·발광하는 실·안개가 반영됐다. 주황색은 분홍빛으로 바뀌었다.
밤의 폐허 도시를 연결하는 발광하는 균사체, 오래된 콘크리트 틈에서 자라난 가느다란 주황색 실, 젖은 바닥의 반사, 청록빛 안개, 낮은 시점의 넓은 풍경, 인간 이후의 생태계를 상상한 영화적인 미디어아트 이미지 --ar 16:9
2026.09.26 생성 · 개인화 q311u7t 적용 · 이미지를 누르면 원문과 후보 4장을 볼 수 있다. 전시장 이미지는 실제 전시 기록이 아닌 구상 이미지다.
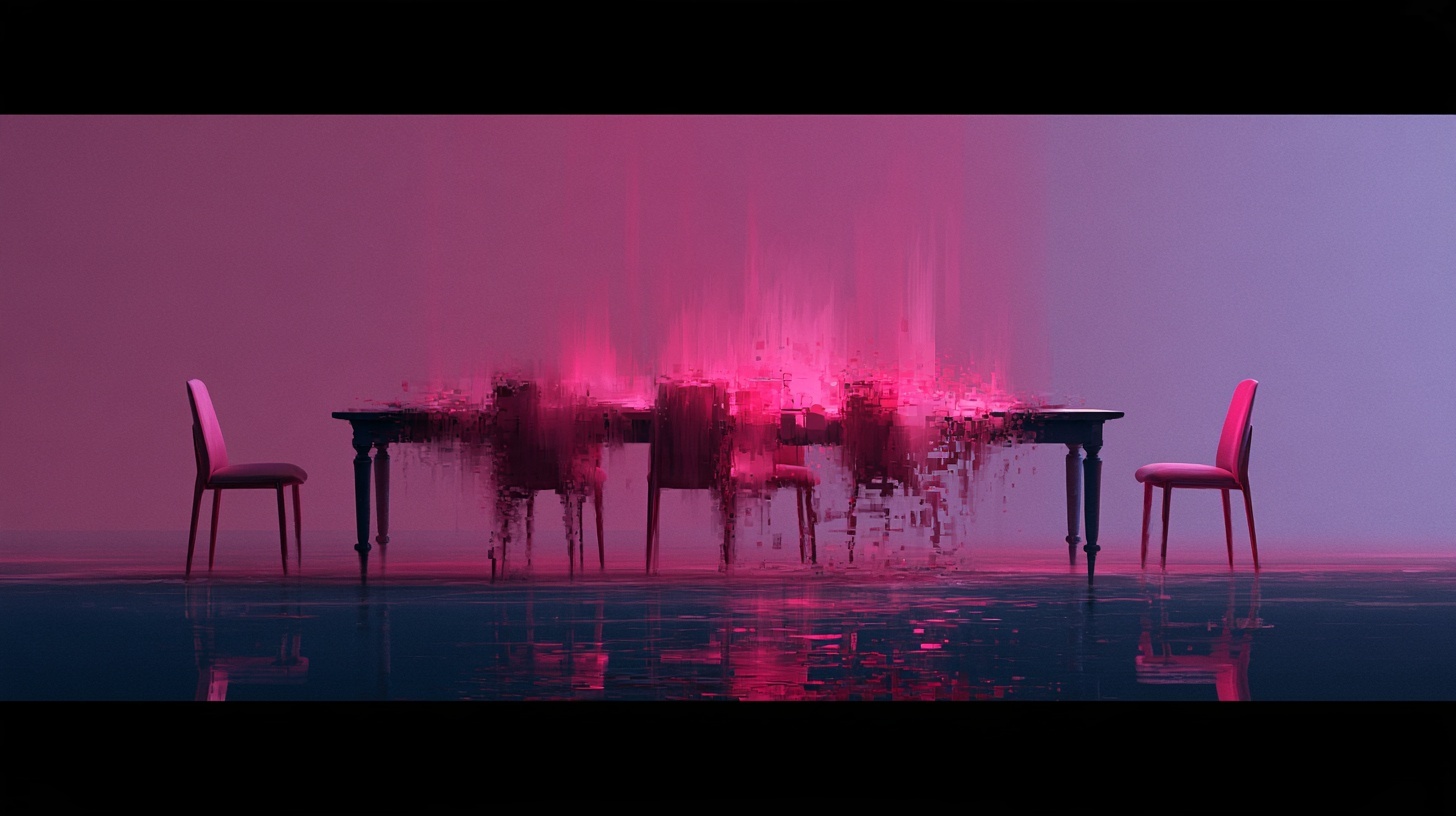
식탁의 형태가 디지털 오류처럼 흐트러졌다. 의자 여섯 개라는 조건은 불명확하다.
텅 빈 가족 식탁과 여섯 개의 의자, 테이블 일부가 가로 방향의 디지털 픽셀 조각으로 흩어진다, 흐릿한 필름 사진과 선명한 디지털 오류의 결합, 바랜 분홍과 짙은 남색, 정면의 대칭 구도, 기억이 손상되는 순간을 표현한 실험적 이미지 --ar 16:9
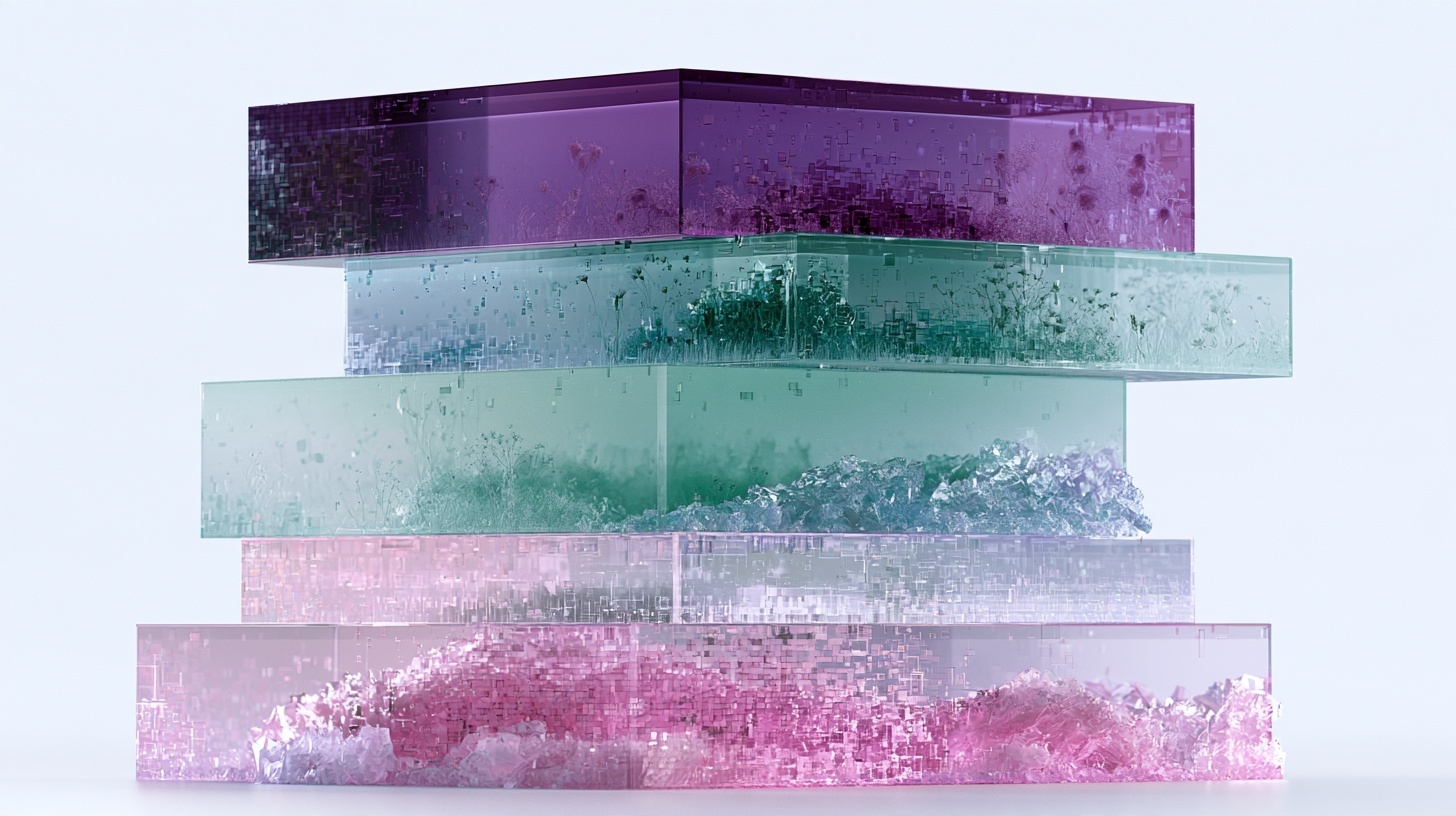
색의 층과 유리 질감이 반영됐다. 이 이미지는 실제 데이터를 시각화한 결과는 아니다.
수평으로 쌓인 반투명 색의 층들이 지층처럼 보이는 추상 이미지, 각 층 안에 작은 사각 픽셀과 흐릿한 식물 흔적, 깊은 보라색과 연두색의 대비, 유리와 광물의 질감, 정밀한 단면 구도, 디지털 기억이 쌓이는 풍경 --ar 16:9
2026.09.26 생성 · 개인화 q311u7t 적용 · 이미지를 누르면 원문과 후보 4장을 볼 수 있다. 전시장 이미지는 실제 전시 기록이 아닌 구상 이미지다.
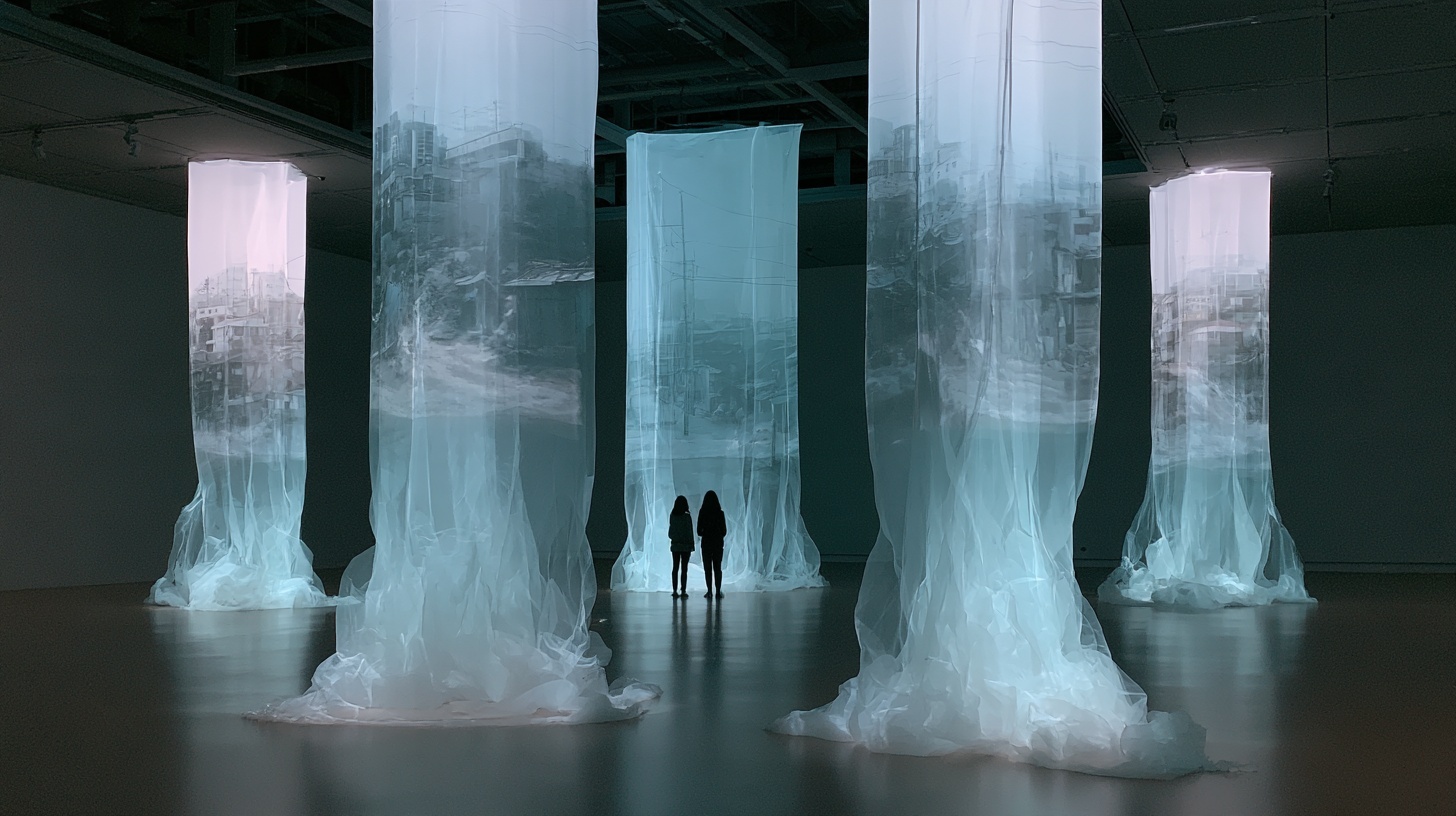
천·투사 영상·관객이 함께 보인다. 실제 설치를 위한 투사 조건은 별도로 검토한다.
어두운 미술관 전시장, 천장에서 바닥까지 늘어진 반투명 천 다섯 장에 오래된 동네의 사진이 겹쳐 투사된다, 천 사이로 보이는 관객 두 명의 작은 실루엣, 푸른 회색 영상빛, 기억의 층이 겹치는 미디어아트 설치, 넓은 전시장 전경, 사실적인 전시 기록 사진 --ar 16:9
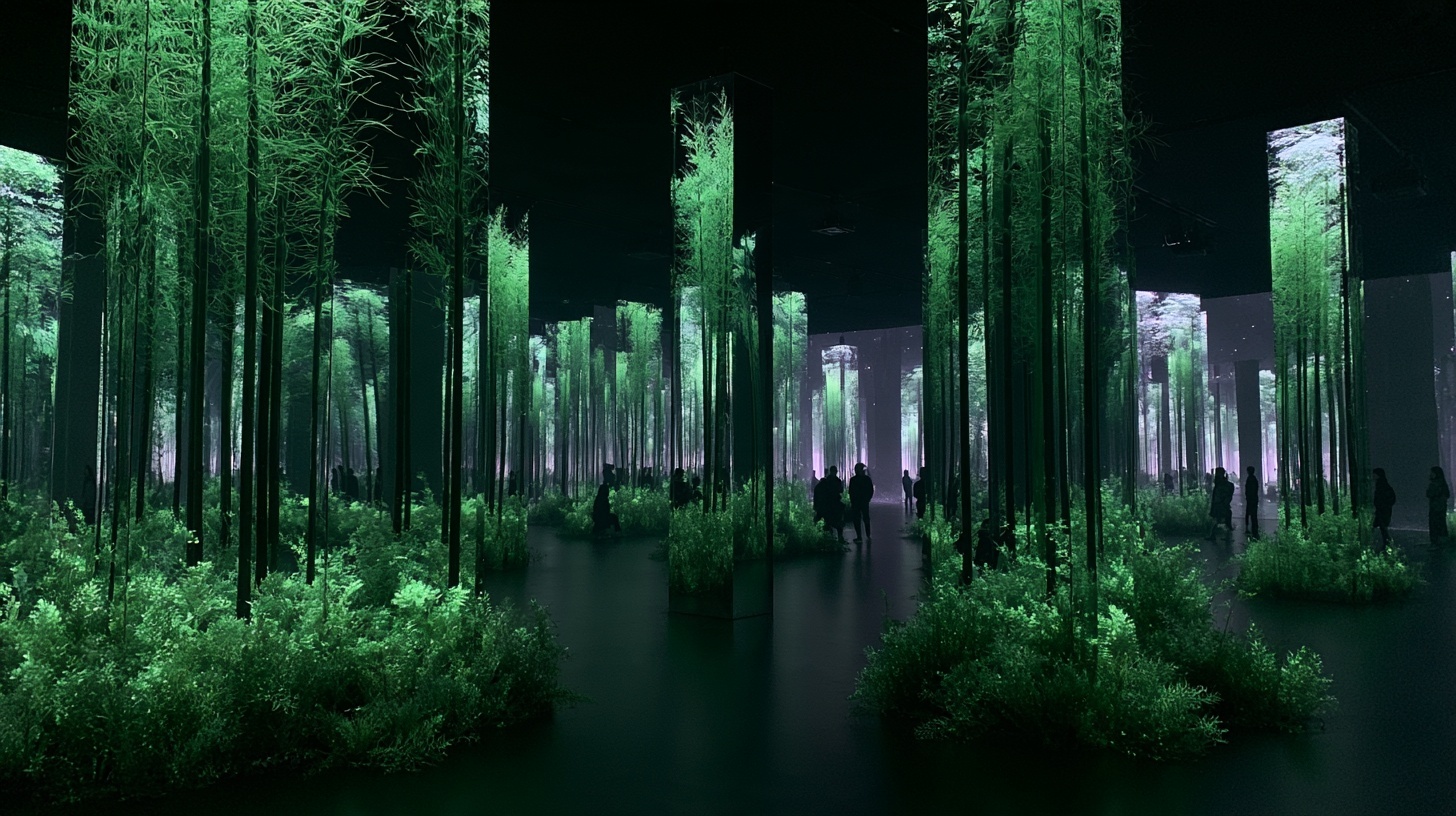
반복된 기둥과 녹색 영상이 깊이를 만든다. 거울과 투사 영상의 구분은 모호하다.
검은 전시장에 거울로 만든 가느다란 기둥들이 숲처럼 서 있다, 기둥 사이로 녹색 식물 영상이 투사되고 반사되어 끝없이 이어진다, 작은 관객 실루엣, 깊은 초록과 검은색, 몰입형 미디어아트 전시장 전경, 사실적인 사진 --ar 16:9
2026.09.26 생성 · 개인화 q311u7t 적용 · 이미지를 누르면 원문과 후보 4장을 볼 수 있다. 전시장 이미지는 실제 전시 기록이 아닌 구상 이미지다.
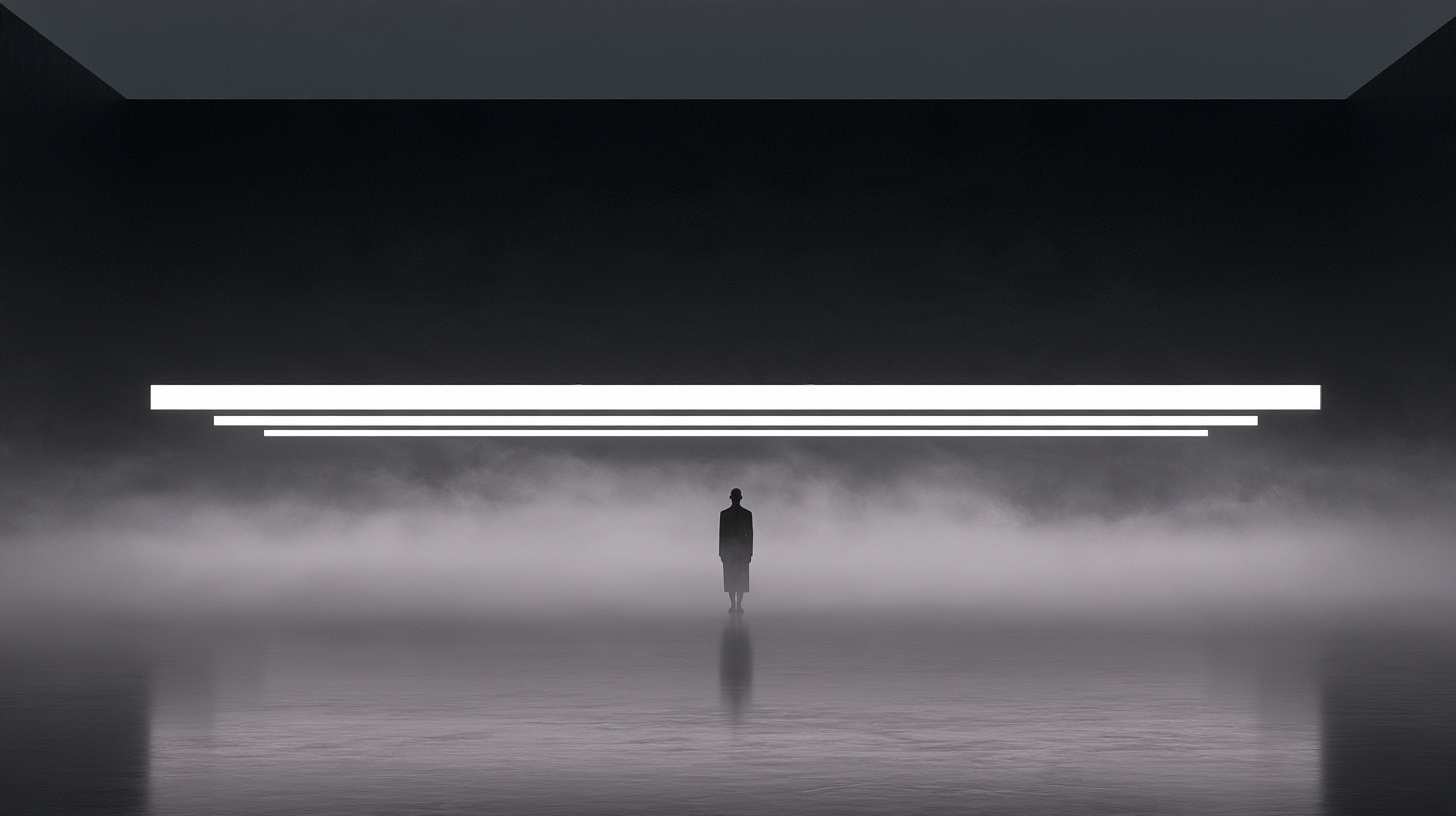
빛의 띠·안개·관객이 공간을 만든다. 측면 구도는 정면에 가깝게 해석됐다.
어두운 직사각형 전시장에 얇은 안개가 깔려 있다, 수평으로 펼쳐진 흰 빛의 평면 세 개가 공중을 가른다, 빛 사이에 서 있는 관객 한 명, 바닥에 희미하게 반사되는 빛, 흑백의 절제된 미디어아트 설치, 측면에서 본 넓은 구도, 사실적인 전시장 구상 사진 --ar 16:9
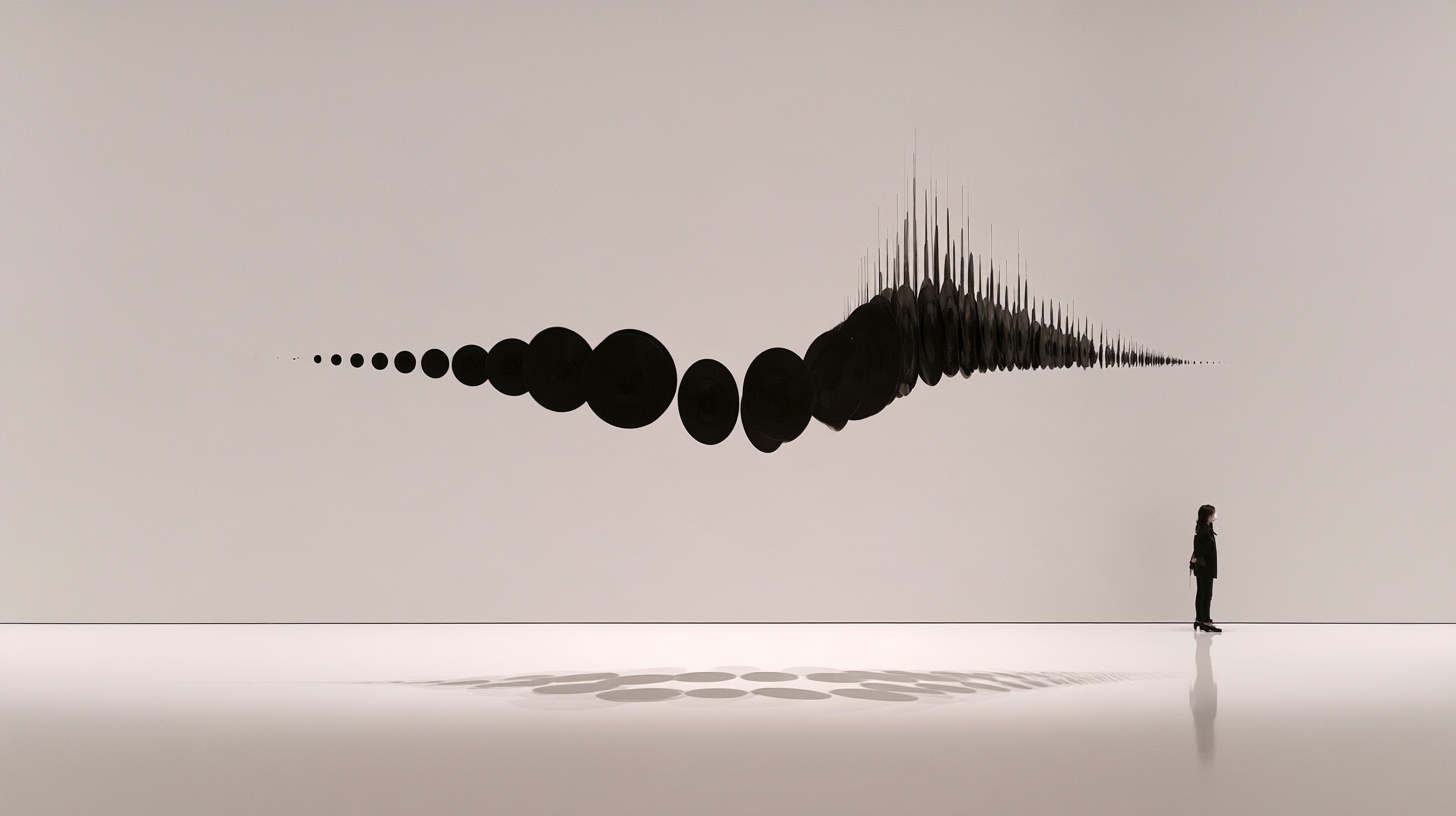
원판의 크기와 높낮이가 파형처럼 보인다. 실제 소리 분석으로 만든 형태는 아니다.
흰 전시장 중앙에 공중으로 떠오르는 검은 원판 수십 개, 원판들이 소리의 파형처럼 높낮이가 다른 곡선을 이룬다, 바닥에 떨어지는 또렷한 그림자, 관객 한 명이 옆에 서 있다, 소리를 형태로 옮긴 설치미술 구상, 미니멀한 전시 기록 사진 --ar 16:9
2026.09.26 생성 · 개인화 q311u7t 적용 · 이미지를 누르면 원문과 후보 4장을 볼 수 있다. 전시장 이미지는 실제 전시 기록이 아닌 구상 이미지다.
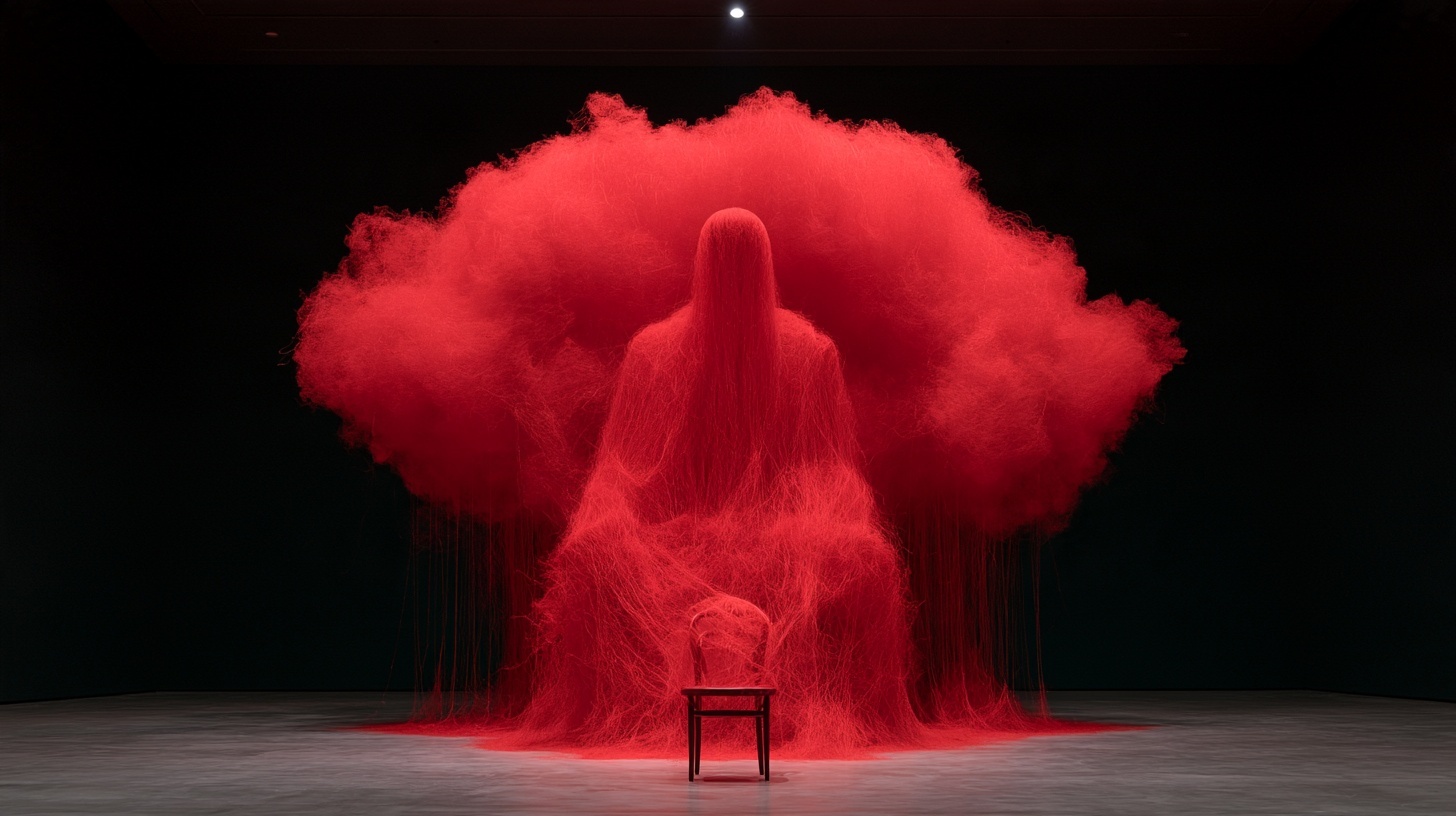
붉은 실과 빈 의자가 반영됐다. 빈 공간의 윤곽 대신 사람 같은 형상이 나타났다.
거대한 검은 전시장 안에 떠 있는 붉은 실의 구름, 수천 가닥의 가느다란 실이 작은 빈 의자 한 개를 감싼다, 실 사이의 빈 공간이 사람의 윤곽처럼 보인다, 부재와 기억을 다루는 설치미술 구상, 붉은색과 검은색의 강한 대비, 천장의 좁은 스포트라이트, 관객 시점의 넓은 전경, 사실적인 전시 사진 --ar 16:9
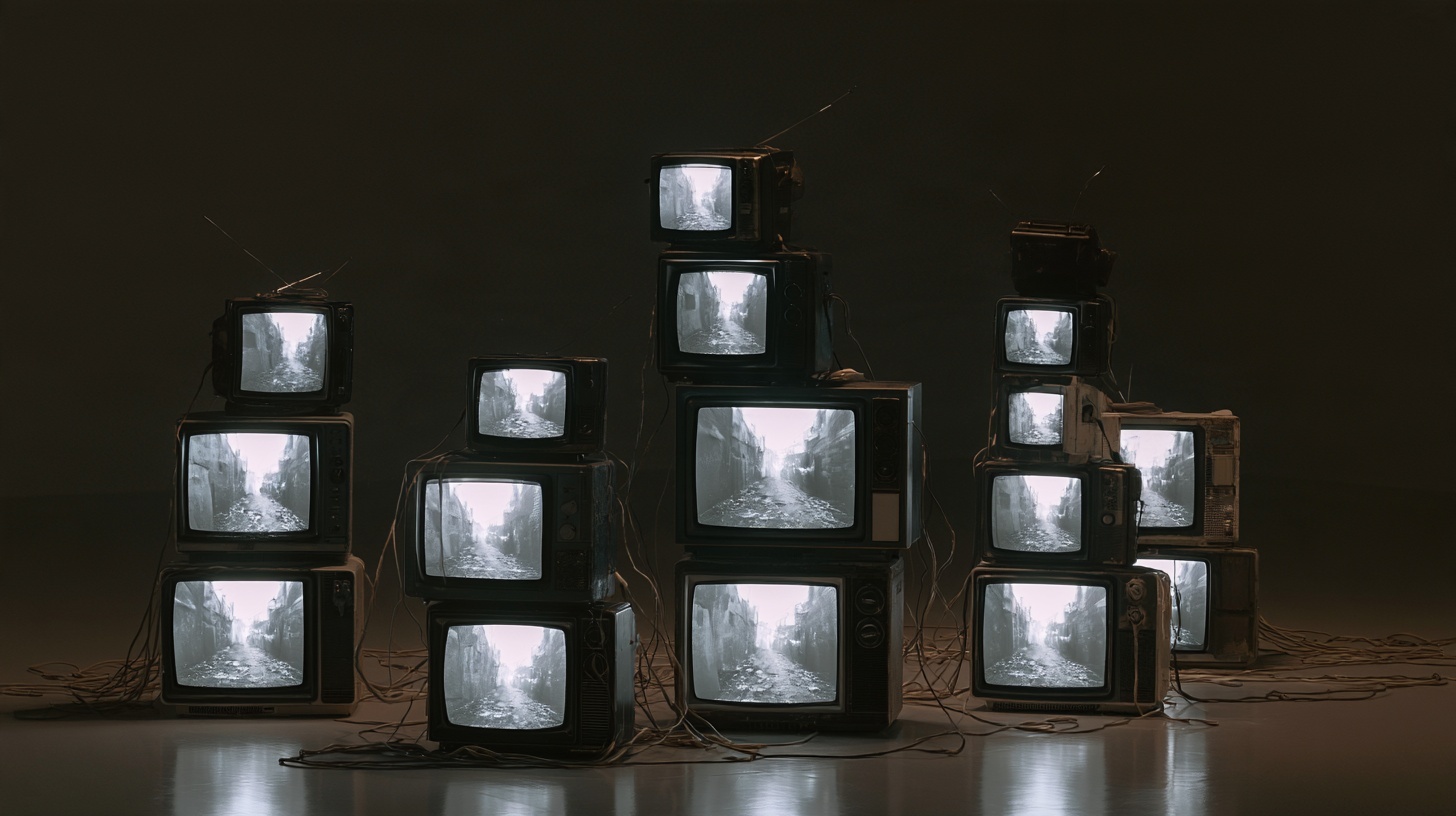
모니터·화면빛·전선이 반영됐다. 화면 수와 각 화면의 내용은 직접 점검한다.
낡은 브라운관 텔레비전 열두 대가 어두운 전시장 바닥에 서로 다른 높이로 놓여 있다, 각 화면에는 비어 있는 방과 오래된 골목의 흑백 영상, 전선이 바닥을 연결한다, 화면빛만으로 밝아진 공간, 아날로그 기억을 주제로 한 비디오 설치 구상 --ar 16:9
2026.09.26 생성 · 개인화 q311u7t 적용 · 이미지를 누르면 원문과 후보 4장을 볼 수 있다. 전시장 이미지는 실제 전시 기록이 아닌 구상 이미지다.
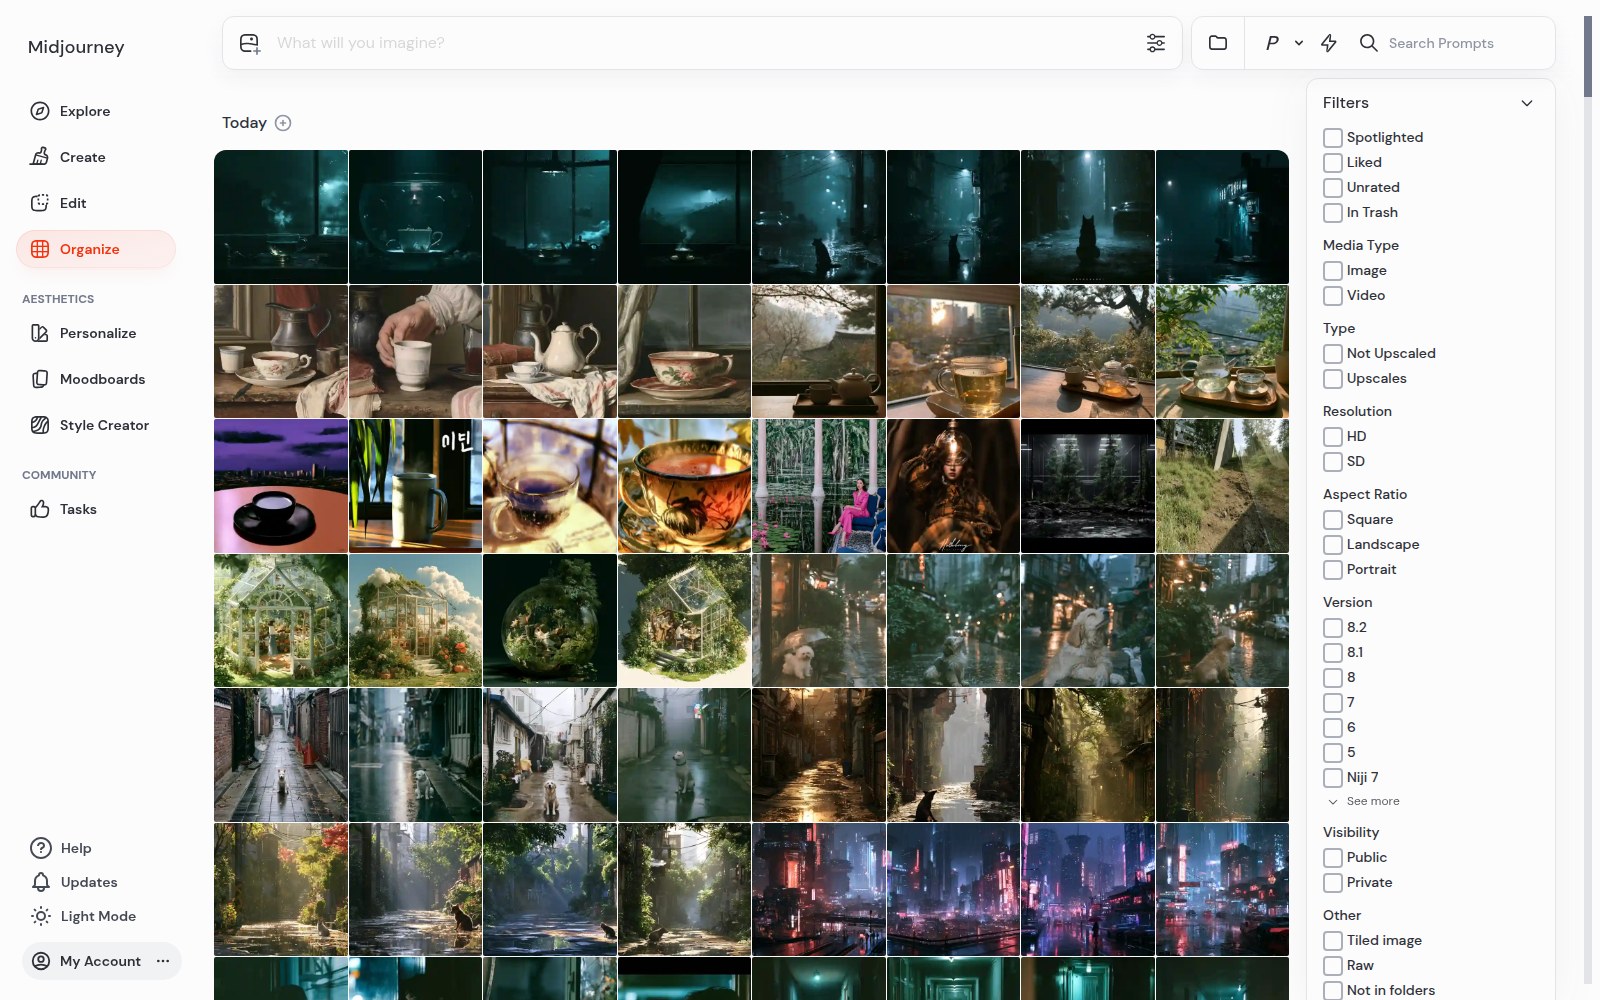
검색 — 프롬프트 단어로 과거 작업을 찾는다. 파라미터로도 검색된다.
폴더 — 과제별로 폴더를 만들어 정리한다. 이 수업은 주차별 폴더를 권한다.
일괄 다운로드 — 드래그나 Shift+클릭으로 여러 장을 선택해 한 번에 내려받는다. 제출물 정리가 빨라진다.
휴지통 주의 — 휴지통에 넣어도 비공개가 되지 않는다. 삭제와 비공개는 다른 문제다.
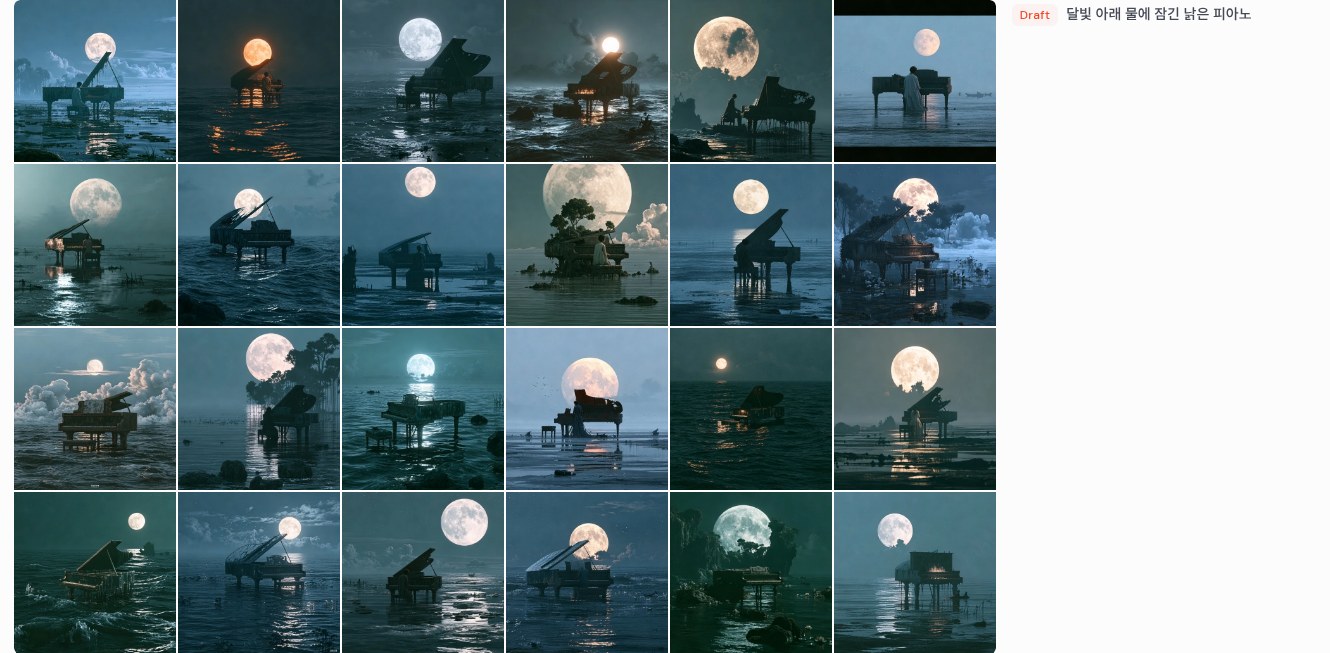
V8.1/V8.2 웹의 Draft는 낮은 해상도 후보 24장으로 방향을 탐색한다. V7은 4장으로 방식이 다르다. 선택한 후보를 Vary 또는 Remix로 다시 생성해 정식 작업으로 이어 간다.
| 방식 | 장수 | 크기 | Fast 시간 | 용도 |
|---|---|---|---|---|
| Draft | 24장 | 512px | 0.4분 | 방향 탐색 |
| 표준(SD) | 4장 | 1024px | 0.8분 | 본 작업 |
| 고해상도(HD) | 4장 | 2048px | 1.3분 | 확정본만 |
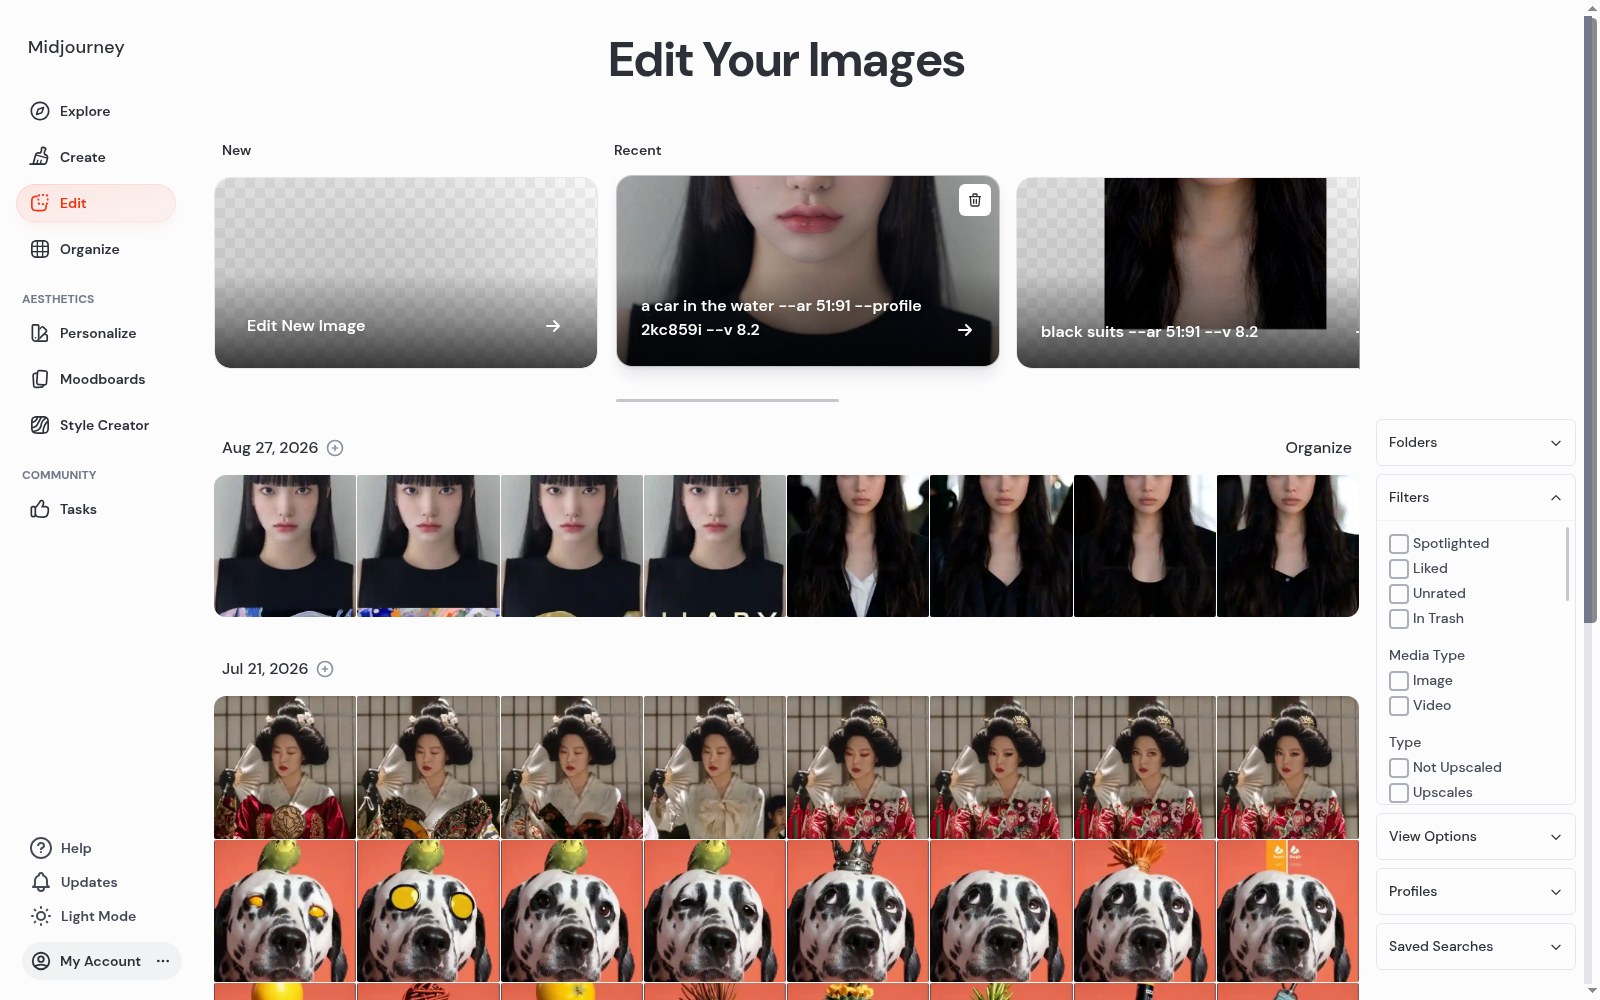
두 진입점 — 생성한 이미지를 열고 Edit 버튼(빠른 편집), 또는 사이드바 Edit 탭(전체 도구).
외부 이미지도 된다 — 내 사진, 블렌더 렌더를 업로드해서 편집할 수 있다(최대 10MB). 외부 이미지 결과물은 나에게만 보인다.
규칙 — 외부 이미지는 권리를 가진 것만. 실존 인물 사진의 조작·합성은 제재 대상이다.
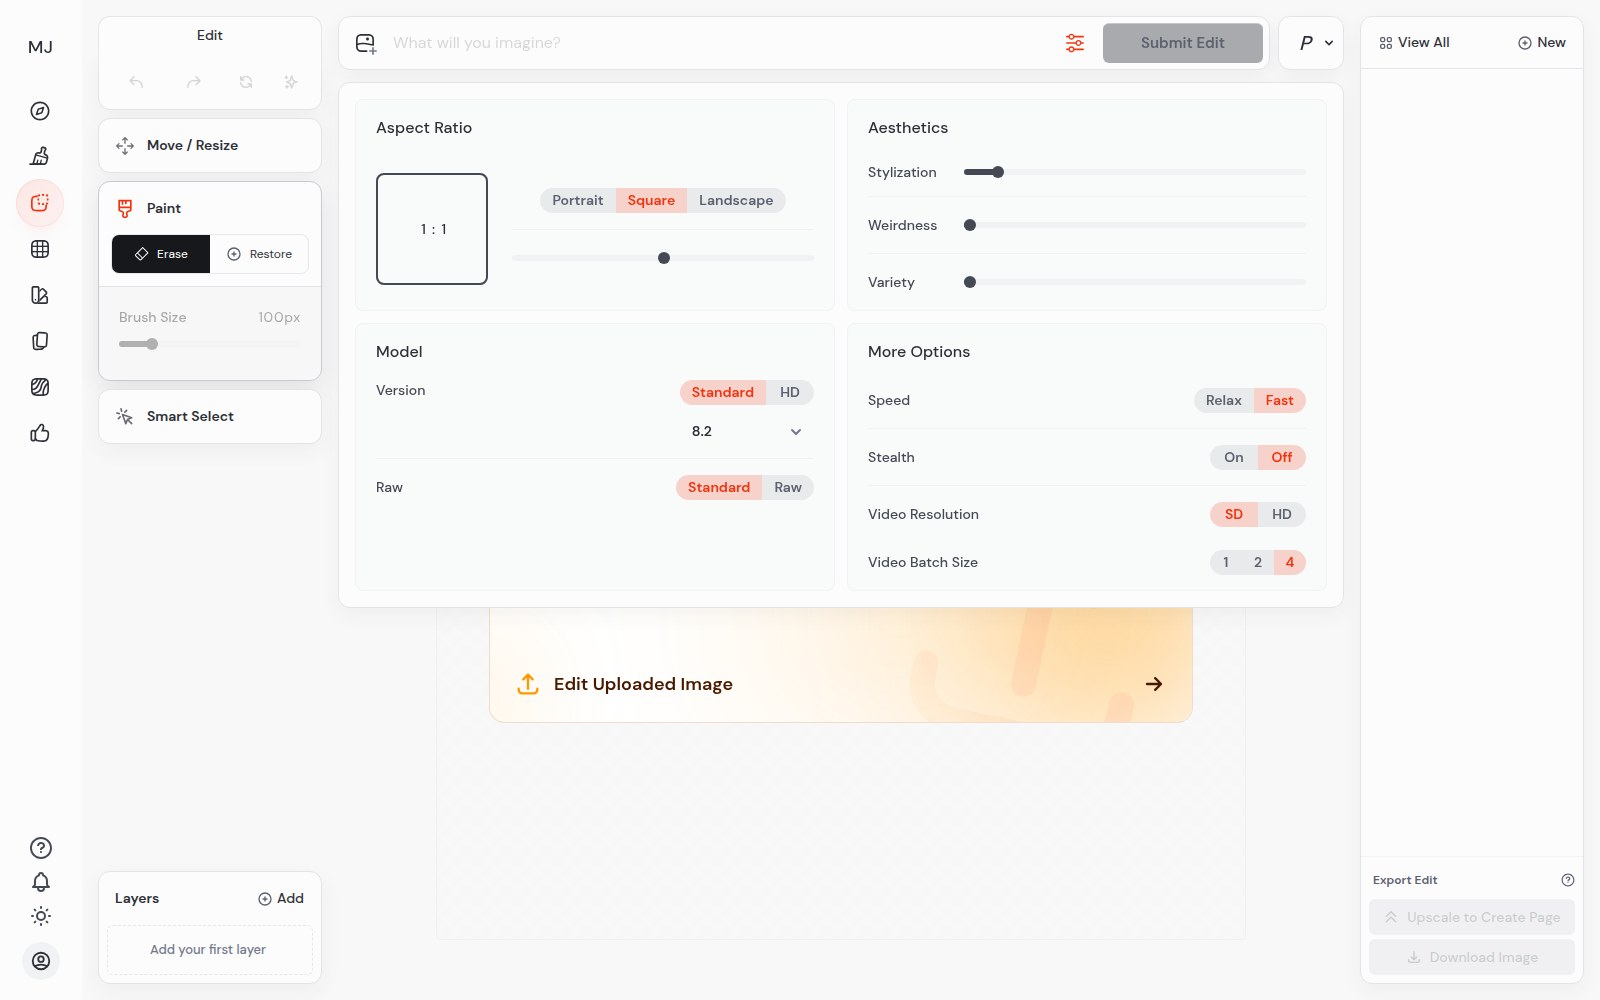
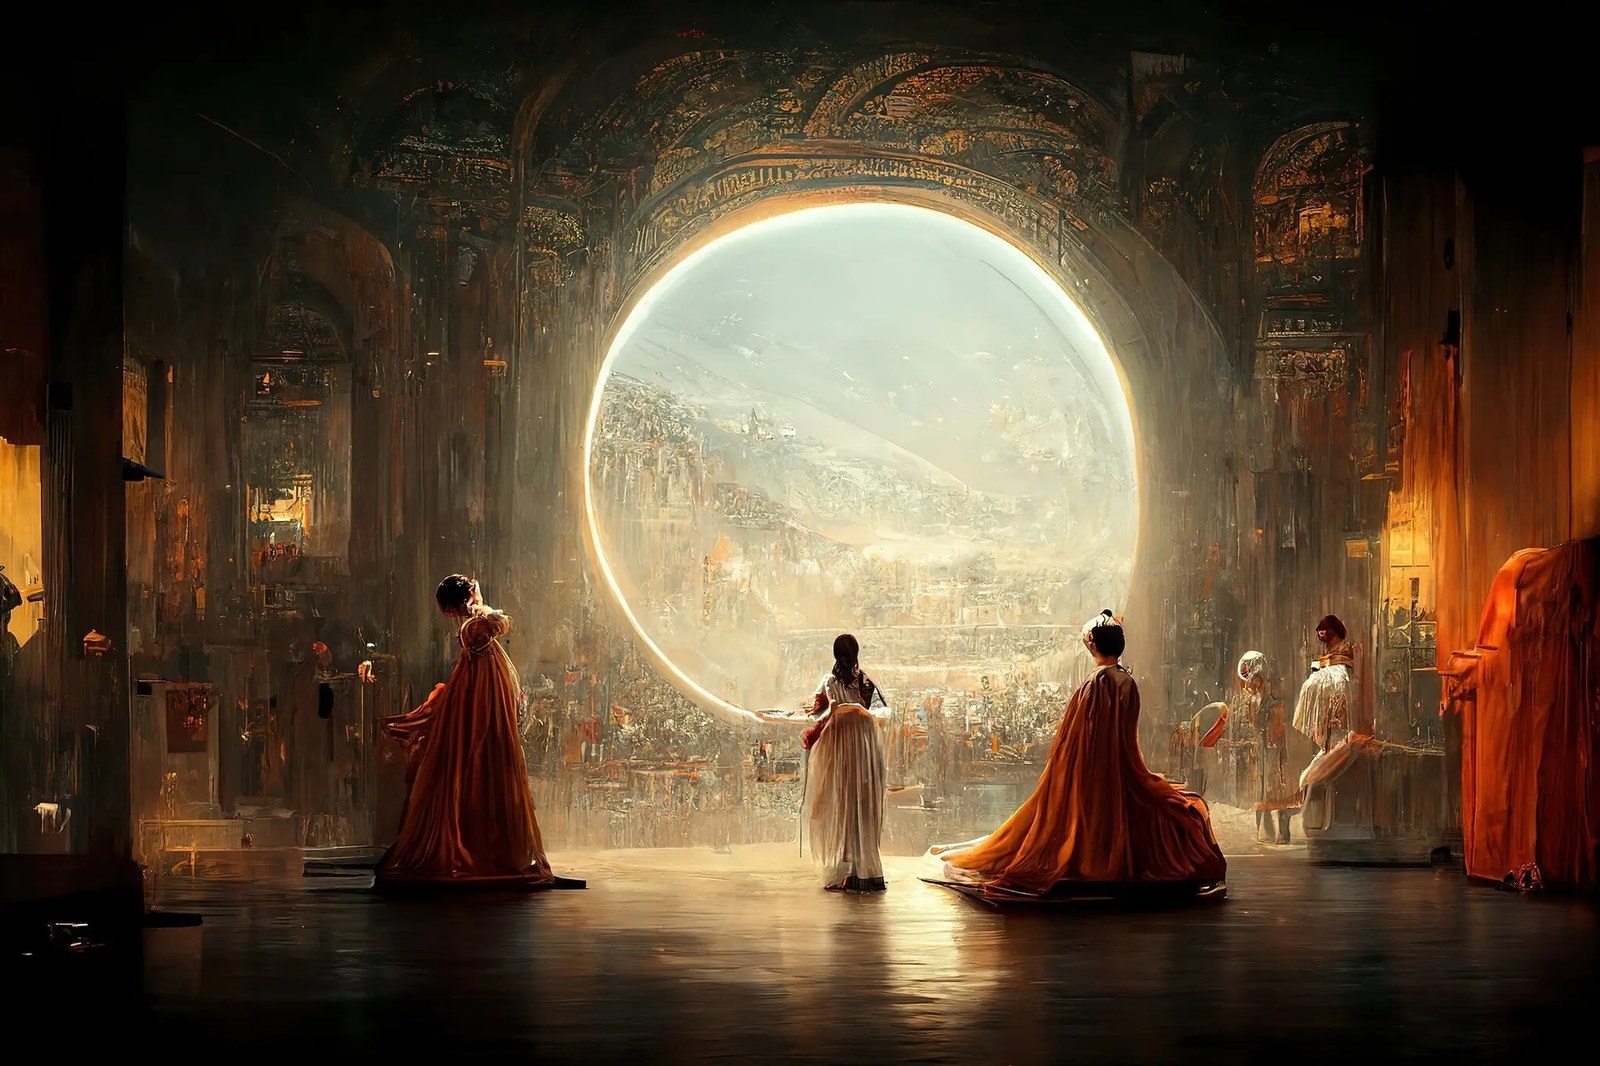
경위 — 제이슨 M. 앨런이 미드저니로 만든 〈스페이스 오페라 극장〉이 2022년 8월 '디지털 아트/디지털 조작 사진' 부문에서 1위를 받았다. 상금 300달러. 출품 시 사용 도구를 밝혔고, 심사위원은 AI로 만든 것인 줄 몰랐다고 밝혔다.
과정 — 앨런은 프롬프트를 최소 624회 수정했다고 진술했다. 이후 확대와 보정을 거쳐 캔버스에 출력했다.
법 — 앨런은 저작권 등록을 신청했고, 미국 저작권청은 2023년 9월 5일 등록을 최종 거부했다. 인간이 창작에 기여한 부분을 특정할 수 없다는 이유였다.
▶ 현지 뉴스 2분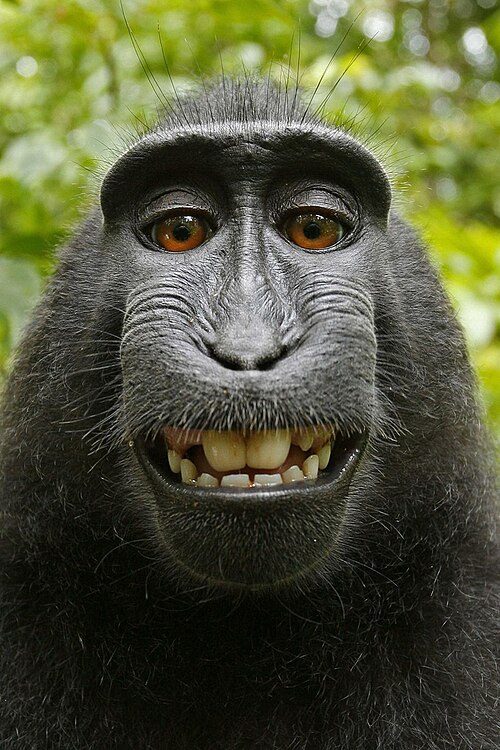
경위 — 2011년 인도네시아 술라웨시. 사진가 데이비드 슬레이터가 세워 둔 카메라를 검정짧은꼬리원숭이가 만지다가 자기 얼굴을 찍었다. 사진이 널리 퍼지자 슬레이터는 저작권을 주장했다.
판단 ① — 미국 저작권청은 2014년 실무편람 제3판에 "인간이 아닌 존재가 만든 저작물은 등록할 수 없다"고 명시했다. 셔터를 누른 것이 원숭이라면 사진에는 저작자가 없다.
판단 ② — 동물보호단체 PETA가 2015년 원숭이를 원고로 소송을 냈고, 2018년 미국 제9순회항소법원은 동물에게 소송 자격이 없다고 판단했다.
결과 — 이 사진은 저작자 없는 이미지, 퍼블릭 도메인으로 취급된다. 지금 이 슬라이드에 쓸 수 있는 이유이기도 하다.