생성형 AI 기반 영상 제작
Understanding the AI-Based Video Content Production Pipeline
01 · 제작 파이프라인 / 감정과 동기
사전적 정의 : 감정과 느낌
재미 [명사]
아기자기하게 즐거운 기분이나 느낌.
일상 속 재미의 예시
좋아하는 음악을 들을 때 저절로 몸이 움직이는 것
게임을 하다가 시간 가는 줄 모르는 것
흥미로운 이야기를 들으며 귀를 기울이게 되는 것
01 · 제작 파이프라인 / 감정과 동기
심리학적 정의 : 내재적 동기
내재적 동기 (Intrinsic Motivation)
— Deci & Ryan, 자기결정이론 (Self-Determination Theory)
외부의 보상 없이 활동 그 자체가 보상이 되는 상태.
몰입(Flow)의 예시
누가 용돈을 줘서가 아니라, 그냥 그림 그리는 행위 자체가 좋아서
몇 시간씩 앉아있는 것.
결과물보다 과정 자체에서 기쁨을 느끼는 상태.
01 · 제작 파이프라인 / 감정과 동기
과학이 말하는 재미 — 도파민
예측 오류 이론 (Prediction Error)
우리 뇌는 끊임없이 다음에 무슨 일이 일어날지 예측합니다. 그리고 그 예측이 빗나갈 때—예상보다 좋은 결과가 나왔을 때—도파민이 분비됩니다.
예상대로 됨: 도파민 변화 없음 (지루하다)
예상보다 좋음: 도파민 폭발 (재미있다! "아!")
예상보다 나쁨: 도파민 억제 (실망)
골디락스 난이도 (Goldilocks Rule)
게임에서 딱 이길 듯 말 듯한 난이도일 때 인간은 가장 큰 재미(도파민 폭발)를 느낍니다. 이는 뇌가 패턴을 학습하고 마스터하는 과정에서 오는 본능적인 쾌감
01 · 제작 파이프라인 / 감정과 동기
"아!" — 재미의 정체
재미는 웃긴 것도, 자극적인 것도 아닙니다. 재미의 정체는 '감탄사'가 터져 나오는 순간입니다.
이 세 가지는 전부 같은 메커니즘입니다.
뇌가 예상하지 못한 것을 만났을 때 일어나는 반응, 과학자들은 이를 "예측 오류(Prediction Error)"라고 부릅니다.
뭔가를 알아챘을 때
"아, 이게 그거였어!"
흩어진 점들이 갑자기 연결되는 순간의 쾌감.
뭔가를 발견했을 때
"어, 이런 게 있었어?"
몰랐던 패턴이나 숨겨진 의도가 보이기 시작하는 순간.
익숙한 것이 낯설어질 때
"엥, 이게 왜 여기에?"
원래 있던 것이 전혀 다른 맥락에서 새롭게 보이는 순간.
01 · 제작 파이프라인 / 감정과 동기
그래서 작가는 무엇을 설계하는가
재미는 우연이 아니라 설계다
완성된 답을 주는 작가보다, 질문을 설계하는 작가가 더 오래 기억됩니다.
기대를 만든다
관객이 다음을 예측하게 한다
기대를 어긴다
그 예측을 정확히 비튼다
빈틈을 남긴다
관객이 스스로 채우게 한다
긴장감의 시작
도파민의 폭발
해석의 여지 = 재미의 여지

01 · 제작 파이프라인 / 창작과 편집
창작이란 무엇인가
인공지능 시대, '만든다'는 것의 의미가 바뀌고 있다
01 · 제작 파이프라인 / 창작과 편집
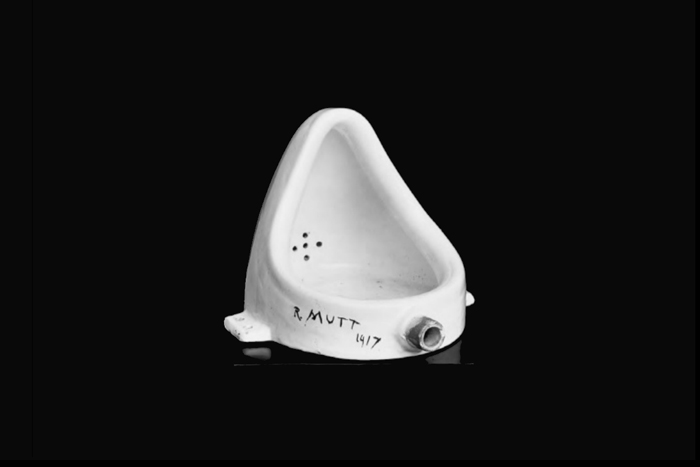
"이 작품을 보신 적 있나요?"
01 · 제작 파이프라인 / 창작과 편집
마르셀 뒤샹 — 변기가 예술이 된 날
마르셀 뒤샹 (Marcel Duchamp)
1887–1968, 프랑스
20세기 현대미술의 흐름을 바꾼 작가. 회화, 조각 등 전통 미술의 경계를 해체하고 "예술이란 무엇인가"라는 질문 자체를 작품으로 만든 인물입니다.
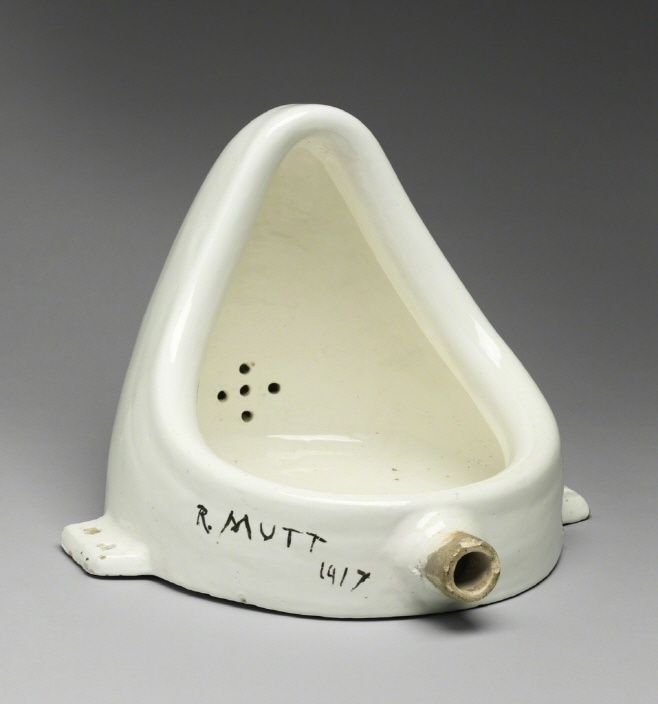
<샘(Fountain)>, 1917
뒤샹은 뉴욕의 배관 용품점에서 남성용 소변기를 구입했습니다.
그 위에 "R. Mutt 1917"이라고 서명했습니다.
미국독립미술가협회 전시에 출품했습니다.
심사위원들은 격분했고, 전시는 거부되었습니다.
💡 2004년 영국 미술 전문가 500명 설문
피카소도, 워홀도 아닌, 이 변기가 "20세기 가장 영향력 있는 미술 작품" 1위로 선정되었습니다.
하지만 이 사건은 미술사의 방향을 완전히 바꿔놓았습니다.
01 · 제작 파이프라인 / 창작과 편집
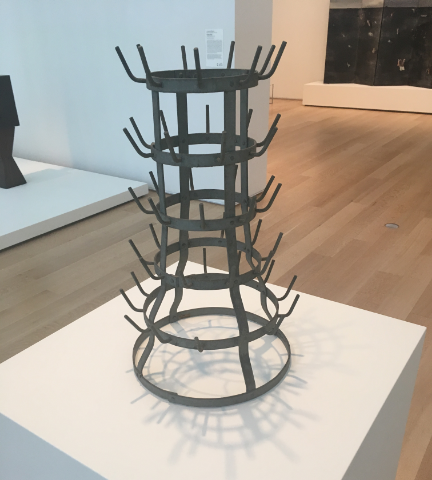
레디메이드(Ready-made) — 선택이 창작이 되는 순간
뒤샹은 변기를 만들지 않았습니다.
공장에서 대량 생산된 기성품을 선택했고, 화장실이 아닌 미술관이라는 새로운 맥락에 놓았습니다. 그 순간, 변기는 더 이상 변기가 아니게 됩니다.
| 핵심 행위 | 설명 |
|---|---|
| 선택 (Selection) | 수많은 사물 중 '이것'을 고른다. |
| 맥락 전환 | 원래 있던 곳에서 다른 곳으로 옮긴다. |
| 관계 재정의 | 보는 사람이 그것을 새롭게 바라보게 한다. |
지금 여러분이 AI로 생성한 이미지도 레디메이드입니다.
AI가 만들어준 이미지 자체는 '재료'일 뿐. 그것을 어디에, 어떤 순서로, 무엇 옆에 놓느냐가 창작입니다.
01 · 제작 파이프라인 / 창작과 편집
창작 = 편집
무에서 유를 만드는 것만이 창작이 아닙니다.
이미 존재하는 것들 사이의 관계를 재구성하는 것. 그것이 AI 시대의 창작입니다.
선택 (Selection)
100장 중 10장을 고른다. 무엇을 남기고 무엇을 버릴 것인가.
배열 (Arrangement)
10장을 어떤 순서로 놓을 것인가. 순서가 바뀌면 이야기가 바뀐다.
연결
(Connection)
앞 이미지와 뒤 이미지 사이에 무엇이 생기는가. 그 '사이'가 의미다.
01 · 제작 파이프라인 / 창작과 편집
에디톨로지(Editology) — 편집의 시대
문화심리학자 김정운 박사가 제안한 개념입니다.
"창조는 무(無)에서 유(有)를 만드는 것이 아니라, 이미 존재하는 것들을 새롭게 연결하는 것이다."
왜 지금 이 개념이 중요한가:
AI가 하루에도 수만 장의 이미지를 생성하는 범람의 시대
더 잘 만드는 것보다 더 잘 고르고 연결하는 것이 경쟁력
편집자의 눈 = AI 시대 크리에이터의 핵심 역량
인공지능 시대의 편집이란:
1.
AI 생성물 중 쓸 수 있는 것을 선별하는 눈
2.
선별한 것들을 의미 있는 순서로 배열하는 구조 감각
3.
배열된 이미지 사이에서 감정의 흐름을 설계하는 연출력
01 · 제작 파이프라인 / 창작과 편집
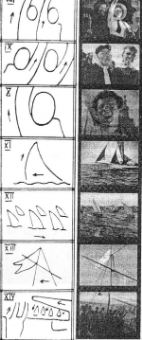
몽타주(Montage) — 이미지 사이에 의미가 태어난다
몽타주는 영화 이론의 가장 핵심적인 개념 (세르게이 에이젠슈테인, 1920년대)
조립'이라는 뜻의 프랑스어에서 유래. 따로 촬영된 쇼트(Shot)들을
이어 붙여서 새로운 의미나 정서를 만들어내는 편집 기법의 총칭
"A + B ≠ A+B.
A + B = C"
이미지 A와 이미지 B를 나란히 놓으면, A도 B도 아닌 전혀 새로운 의미 C가 탄생합니다.
단 한 장의 자막도 없이, 이미지의 배열만으로 메시지를 전달합니다. 여러분이 만드는 AI 영상도 마찬가지입니다. 이미지 하나하나는 '단어'이고, 배열이 '문장'을 만듭니다.
01 · 제작 파이프라인 / 창작과 편집
쿨레쇼프 효과 — 맥락이 감정을 결정한다
레프 쿨레쇼프 (Lev Kuleshov)의 1920년대 실험: 동일한 남자의 무표정한 얼굴을 촬영한 뒤, 그 앞에 세 가지 다른 이미지를 배치했습니다.
같은 이미지도 앞뒤에 무엇이 오느냐에 따라 의미가 완전히 달라집니다.
이것이 바로 여러분이 이미지를 '잘 배열'해야 하는 이유입니다.
01 · 제작 파이프라인 / 창작과 편집
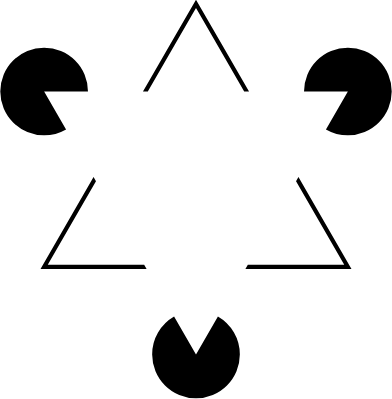
폐합의 원리(Closure) — 빈 공간을 채우는 뇌
게슈탈트 심리학
인간의 뇌는 불완전한 정보를 받으면 자동으로 빈 부분을 채워서 완성된 형태로 인식합니다.
예시: 카니자 삼각형 (Kanizsa Triangle)
영상에서의 폐합:
장면 A: 남자가 문을 열고 어두운 방으로 들어간다
장면 B: (컷) 비명 소리
관객의 뇌가 채우는 것: 방 안에서 끔찍한 일이 벌어졌다.
영상이 강력한 이유: 보여주지 않는 것이 보여주는 것보다 더 강렬합니다. 관객은 빈 공간을 적극적이고 능동적으로 메워나갑니다.
01 · 제작 파이프라인 / 창작과 편집
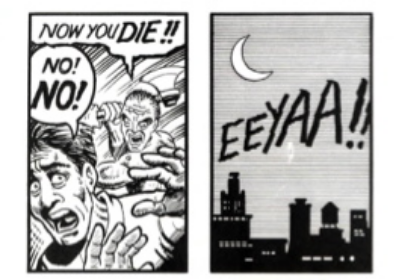
칸 사이 빈틈 효과(Gutter Effect) — 칸 사이에서 이야기가 완성된다
스콧 맥클라우드 (Scott McCloud)가 제안한 개념입니다.
만화에서 칸(panel)과 칸 사이의 빈 공간을 '홈통(Gutter)'이라고 부릅니다.
"칸 1에서 도끼를 들었고, 칸 2에서 비명이 들렸다.
그 사이에서 무슨 일이 벌어졌는지는 보여주지 않았다.
하지만 여러분의 뇌는 이미 그 장면을 상상으로 완성했다."
영상에서의 홈통:
AI 영상에서 가장 중요한 것은 각각의 클립이 아니라,
클립과 클립 '사이'입니다. 관객이 그 사이를 상상으로 채울 수 있도록 맥락을 설계하는 것이 여러분의 역할입니다.
영상의 컷과 컷 사이 = 만화의 홈통
AI 영상은 5~10초 단위 클립의 조합 → 클립 사이의 '홈통'이 매우 많다!
01 · 제작 파이프라인 / 창작과 편집
영상의 기본 단위
시퀀스 (Sequence)
가장 큰 단위
하나의 주제나 사건을 다루는 장면들의 묶음입니다.
(예: 추격 시퀀스)
씬 (Scene)
시공간 단위
동일한 시간과 장소에서 연속적으로 일어나는 행동 단위입니다.
샷 (Shot)
촬영의 단위
카메라가 한 번 돌아가기 시작해서 멈출 때까지의 연속 촬영 단위로, AI 프롬프트의 핵심 단위입니다.
프레임 (Frame)
최소 단위
영상을 구성하는 최소 단위인 정지 이미지 1장입니다. (예: 1초 = 24 프레임)
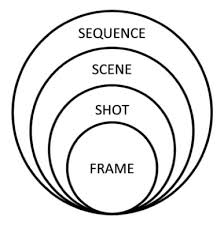
The Holonic Structure of Moving Image Frames, Shots, Scenes and Sequences. (Mark Allan Kaplan, 2016)
01 · 제작 파이프라인 / 제작 단계
영상 제작 파이프라인:
전통적 방법 vs AI가 바꾼 것
촬영이 사라진 자리를 '설계'가 채운다.
01 · 제작 파이프라인 / 제작 단계
전통 영상 제작 파이프라인
1. 프리프로덕션 (Pre-production)
기간: 수주 ~ 수개월
기획서 작성 → 시나리오 → 콘티/스토리보드 → 캐스팅 →
로케이션 헌팅 → 미술/의상 준비
2. 프로덕션 (Production)
인력: 10~30명 | 기간: 수일 ~ 수개월
촬영팀 편성 (감독, 촬영, 조명, 미술, 음향, 배우)
현장 촬영: 조명 세팅 → 리허설 → 현장 사운드
3. 포스트프로덕션 (Post-production)
기간: 수주 ~ 수개월
컷 편집 → 색보정(DI) → VFX → 사운드 디자인 → 믹싱 → 마스터링
비용: 수백만 ~ 수천만 원 (숏폼 기준)
핵심 역량: 현장 촬영 기술 + 팀 매니지먼트 + 예산 관리
01 · 제작 파이프라인 / 제작 단계
AI 영상 제작 파이프라인
1. 프리프로덕션
기간: 수일
시나리오(LLM) → AI 이미지 생성(캐릭터/배경 기준 확보) → Shot Bible 작성
2. 프로덕션
기간: 수시간 ~ 수일
AI 영상 생성 (Sora/Runway/Kling 등)
촬영팀, 카메라, 조명, 배우 없음. 오직 프롬프트.
3. 포스트프로덕션
기간: 수일
편집 (Premiere/CapCut) → AI 사운드 (ElevenLabs/Suno)
비용: AI 구독료 (월 수십만 원)
핵심 역량: 기획력 + 프롬프트 설계 + 일관성 관리
01 · 제작 파이프라인 / 제작 단계
무엇이 변했고, 무엇은 그대로인가
| 영역 | 전통 영상 제작 | AI 시대 영상 제작 |
|---|---|---|
| 촬영 | 카메라 + 조명 + 배우 | 사라짐 → AI 영상 생성으로 대체 |
| 캐스팅 | 배우 오디션, 출연료 | 사라짐 → 캐릭터 기준 이미지로 대체 |
| 로케이션 | 장소 헌팅, 대관료 | 사라짐 → 공간 기준 이미지로 대체 |
| 기획/시나리오 | 필수 | 그대로 — 오히려 더 중요해짐 |
| 편집 | 컷 편집, 색보정 | 그대로 — 맥락 연결을 위해 필수 |
| 일관성 관리 | 카메라 앞에서는 자연스럽게 유지됨 | 가장 어려운 문제 (AI의 최대 약점) |
촬영이 사라진 자리를 "설계"가 채웁니다.
실사에서는 자동으로 유지되던 일관성이, AI에서는 의도적으로 관리되어야 합니다. 그래서 Shot Bible이 필요합니다.
01 · 제작 파이프라인 / 제작 단계
각 단계별 AI 영상 제작 도구 맵
| 단계 | 역할 및 프로세스 | 주요 도구 (Tools) |
|---|---|---|
| 시나리오 | 스토리 구조, 대사, 세계관 기획 | ChatGPT, Claude, Gemini |
| 이미지 생성 | 캐릭터/배경/소품 기준 이미지 도출 | Midjourney, Flux, DALL-E |
| 이미지 교정 & 샷 설계 | 로컬 디테일 일관성 조정 및 시간순 배열 | Nano Banana, Google Mixboard |
| 영상 생성 | 레퍼런스 이미지 + 텍스트 → 5~10초 클립 | Sora, Runway Gen-3, Kling, Vidu |
| 사운드 | 대사, 보이스오버, BGM, SFX 합성 | ElevenLabs, Suno, Udio |
| 편집 | 컷편집, 색보정, 자막 | Premiere Pro, DaVinci, CapCut |
01 · 제작 파이프라인 / 제작 단계
제작 파이프라인 전체 구조
기획
✓
↓
스토리보드
✓
↓
이미지 생성
✓
↓
샷 설계 (현재 진행 단계)
↓
영상 생성
↓
사운드
↓
편집
이 수업은 파이프라인의 허브 역할을 합니다.
01 · 제작 파이프라인 / 제작 단계
제작 과정의 구조
02 · 영상 생성 기초 / 작동 원리와 생성 방식
AI 영상 생성이란 무엇인가?
영상 = 시간이 추가된 이미지
사진(이미지): 세상의 한 순간을 픽셀로 기록한 것
영상(비디오): 1초에 24~30장의 이미지가 연속으로 이어진 것 (시간이라는 3번째 차원 추가)
AI를 활용한 영상 만들기가 어려운 이유
10초짜리 영상 = 약 300장의 이미지를 연속으로 생성해야 합니다. AI는 이 300장을 문맥에 맞게, 물리적으로 자연스럽게 만들어야 합니다.
1프레임이 흔들리면: 깜빡거림 발생 (Flickering)
프레임마다 달라지면: 일관성 붕괴
02 · 영상 생성 기초 / 작동 원리와 생성 방식
이미지 생성 vs 영상 생성, 무엇이 다른가?
| 항목 | 이미지 생성 | 영상 생성 |
|---|---|---|
| 출력물 | 그림 1장 | 수백~수천 장의 연속 이미지 |
| AI 구조 | 2D (가로 × 세로) | 3D (가로 × 세로 × 시간) |
| 핵심 과제 | "어떻게 생겼는가" | "어떻게 생겼는가" + "어떻게 움직이는가" |
| 프롬프트 | 외형만 묘사 | 외형 + 움직임 + 시간 흐름 묘사 |
| 난이도 | 어려움 | 훨씬 더 어려움 (수십 배의 계산량) |
이미지 생성은 사진작가의 일, 영상 생성은 사진작가 + 물리학자 + 감독의 일을 AI가 동시에 하는 것입니다.
02 · 영상 생성 기초 / 작동 원리와 생성 방식
어떻게 만들어지는가? — 작동 원리
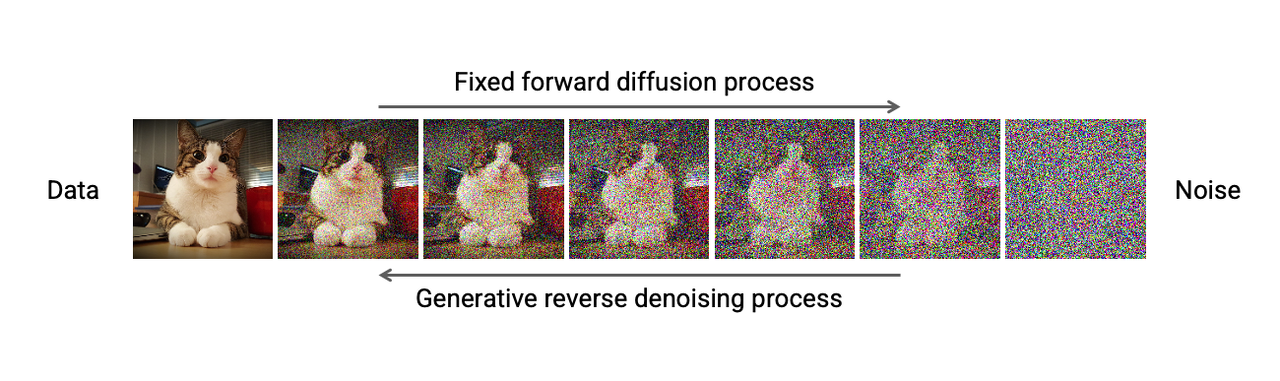
1. 노이즈 지우기
기본 원리는 역방향 잡음 제거입니다. 완전한 랜덤 잡음에서 출발하여, 텍스트 프롬프트를 바탕으로 노이즈를 조금씩 지워나가며 깨끗한 영상을 완성합니다.
2. 시간적 일관성 확보
1장씩 따로 그리면 깜빡임이 발생합니다. 영상 모델은 가로·세로에 '시간축(time axis)'을 추가하여 전체 흐름을 한 번에 통합하여 생성합니다.
3. DiT 아키텍처 도입
영상을 시공간 조각(patch)으로 나누고, 트랜스포머 기술을 활용해 전체 맥락을 한꺼번에 파악합니다. 최신 AI 영상 도구들의 핵심 기술입니다.
02 · 영상 생성 기초 / 작동 원리와 생성 방식
AI 영상 생성 도구 타임라인 (1부: 2023–2024)
2023년
"태동기"
Runway Gen-1, Gen-2 등장. 3-5초 생성 가능. 호기심 수준의 실험적 용도.
2024년 2월
"Sora 쇼크"
OpenAI Sora 발표. 60초 생성, 압도적 품질. 영상 생성 시대의 본격 개막.
2024년 6월
"Kling 1.0 출시"
중국 Kuaishou 개발. 120초 생성. Sora보다 먼저 글로벌 실용화 성공.
2024년 12월
"정식 서비스 경쟁"
Sora 공개 서비스 시작. Runway Gen-3 Alpha 출시. 경쟁 심화.
강의 원본: 2026년 4월
02 · 영상 생성 기초 / 작동 원리와 생성 방식
AI 영상 생성 도구 타임라인 (2부: 2025–2026)
2025년
"품질 급상승"
Google Veo 시리즈, Runway Gen-4 등 각 도구 1080p 이상 고품질 도달.
2025년 12월
"오디오 혁명"
Kling 2.6 출시. 영상과 오디오(효과음, 배경음)를 한 번에 동시 생성 시작.
2026년 2월
"Seedance 2.0 등극"
ByteDance 개발. 글로벌 리더보드 1위 달성. 멀티샷 단일 생성 기술 도입.
2026년 3월
"판도 변화"
Kling 3.0 출시 및 OpenAI Sora 서비스 종료 발표. 영원한 1위는 없음.
강의 원본: 2026년 4월
02 · 영상 생성 기초 / 작동 원리와 생성 방식
영상 생성의 변화 · 참고 영상
02 · 영상 생성 기초 / 작동 원리와 생성 방식
기대치 설정: AI가 잘하는 것 vs 못하는 것
AI가 잘 하는 것
5~15초 길이의 고품질 단편 클립 생성
자연 배경, 추상 장면, 풍경의 시각화
부드러운 카메라 무브먼트 (Pan, Dolly 등)
물리적 현상 (파도, 연기, 빛) 표현
AI가 아직 어려운 것
30초 이상의 일관된 장편 서사 유지
영상 내 텍스트(글자) 정확하게 렌더링
여러 인물의 복잡한 물리적 상호작용
동일 캐릭터를 여러 씬에 걸쳐 완벽히 유지
02 · 영상 생성 기초 / 작동 원리와 생성 방식
현재 AI 영상 생성 생태계 (Big 5 현황)
| 도구 이름 | 개발사 / 국가 | 최신 버전 | 특징 한 줄 요약 |
|---|---|---|---|
| Kling (클링) | Kuaishou (중국) | 3.0 (26.03) | 정밀 카메라 제어 기능과 오디오 동시 생성 지원의 강자 |
| Veo (비오) | DeepMind (구글) | 3.1 (26.01) | 4K 화질, 네이티브 오디오 및 압도적인 물리 시뮬레이션 |
| Seedance | ByteDance (중국) | 2.0 (26.02) | 현재 리더보드 1위. 여러 씬을 한 번에 만드는 멀티샷 기능 |
| Runway | Runway ML (미국) | Gen-4.5 (25.12) | 모션 브러시 등 전문가용 편집 워크플로우 특화 |
| Sora (소라) | OpenAI (미국) | 버전 2 | ⚠️ 2026.04 웹앱 서비스 종료 예정 (초기 시장 개척자) |
강의 원본: 2026년 4월
02 · 영상 생성 기초 / 작동 원리와 생성 방식
영상 생성 방식 3가지: 어디서 시작하는가?
Text-to-Video [T2V]
"글로 영상을 만든다"
가장 진입 장벽이 낮습니다. 텍스트 프롬프트만으로 아이디어를 즉각 시각화할 수 있지만, 매번 새로운 결과물이 나와 일관성 유지가 어렵습니다.
Image-to-Video [I2V]
"사진으로 영상을 만든다"
이미지를 출발점으로 고정하여 캐릭터와 배경의 외형 일관성을 확보합니다. 이를 위해 '샷의 언어'와 레퍼런스 이미지가 필수적입니다.
Video-to-Video [V2V]
"영상을 변환한다"
기존 영상의 모션이나 스타일을 다른 형태로 바꿉니다. 최근 숏폼 밈 제작에 많이 활용되나, 변환 과정에서 품질 저하와 제약이 많습니다.
02 · 영상 생성 기초 / 텍스트 기반 영상 생성
Text-to-Video [T2V]
"글로 영상을 만든다"
02 · 영상 생성 기초 / 텍스트 기반 영상 생성
Tiled Text: 영상용 프롬프트 구조
영상 프롬프트 = 이미지 프롬프트 + 움직임 요소
피사체/행동
카메라 무브먼트
배경/환경
샷 사이즈
분위기/스타일
+
+
+
+
반드시 포함할 요소
움직임 묘사: 무엇이 어떻게 움직이는가
카메라 움직임 지정: 줌, 패닝, 달리 등
시간적 흐름: 서서히 / 빠르게 / 멈춤 등
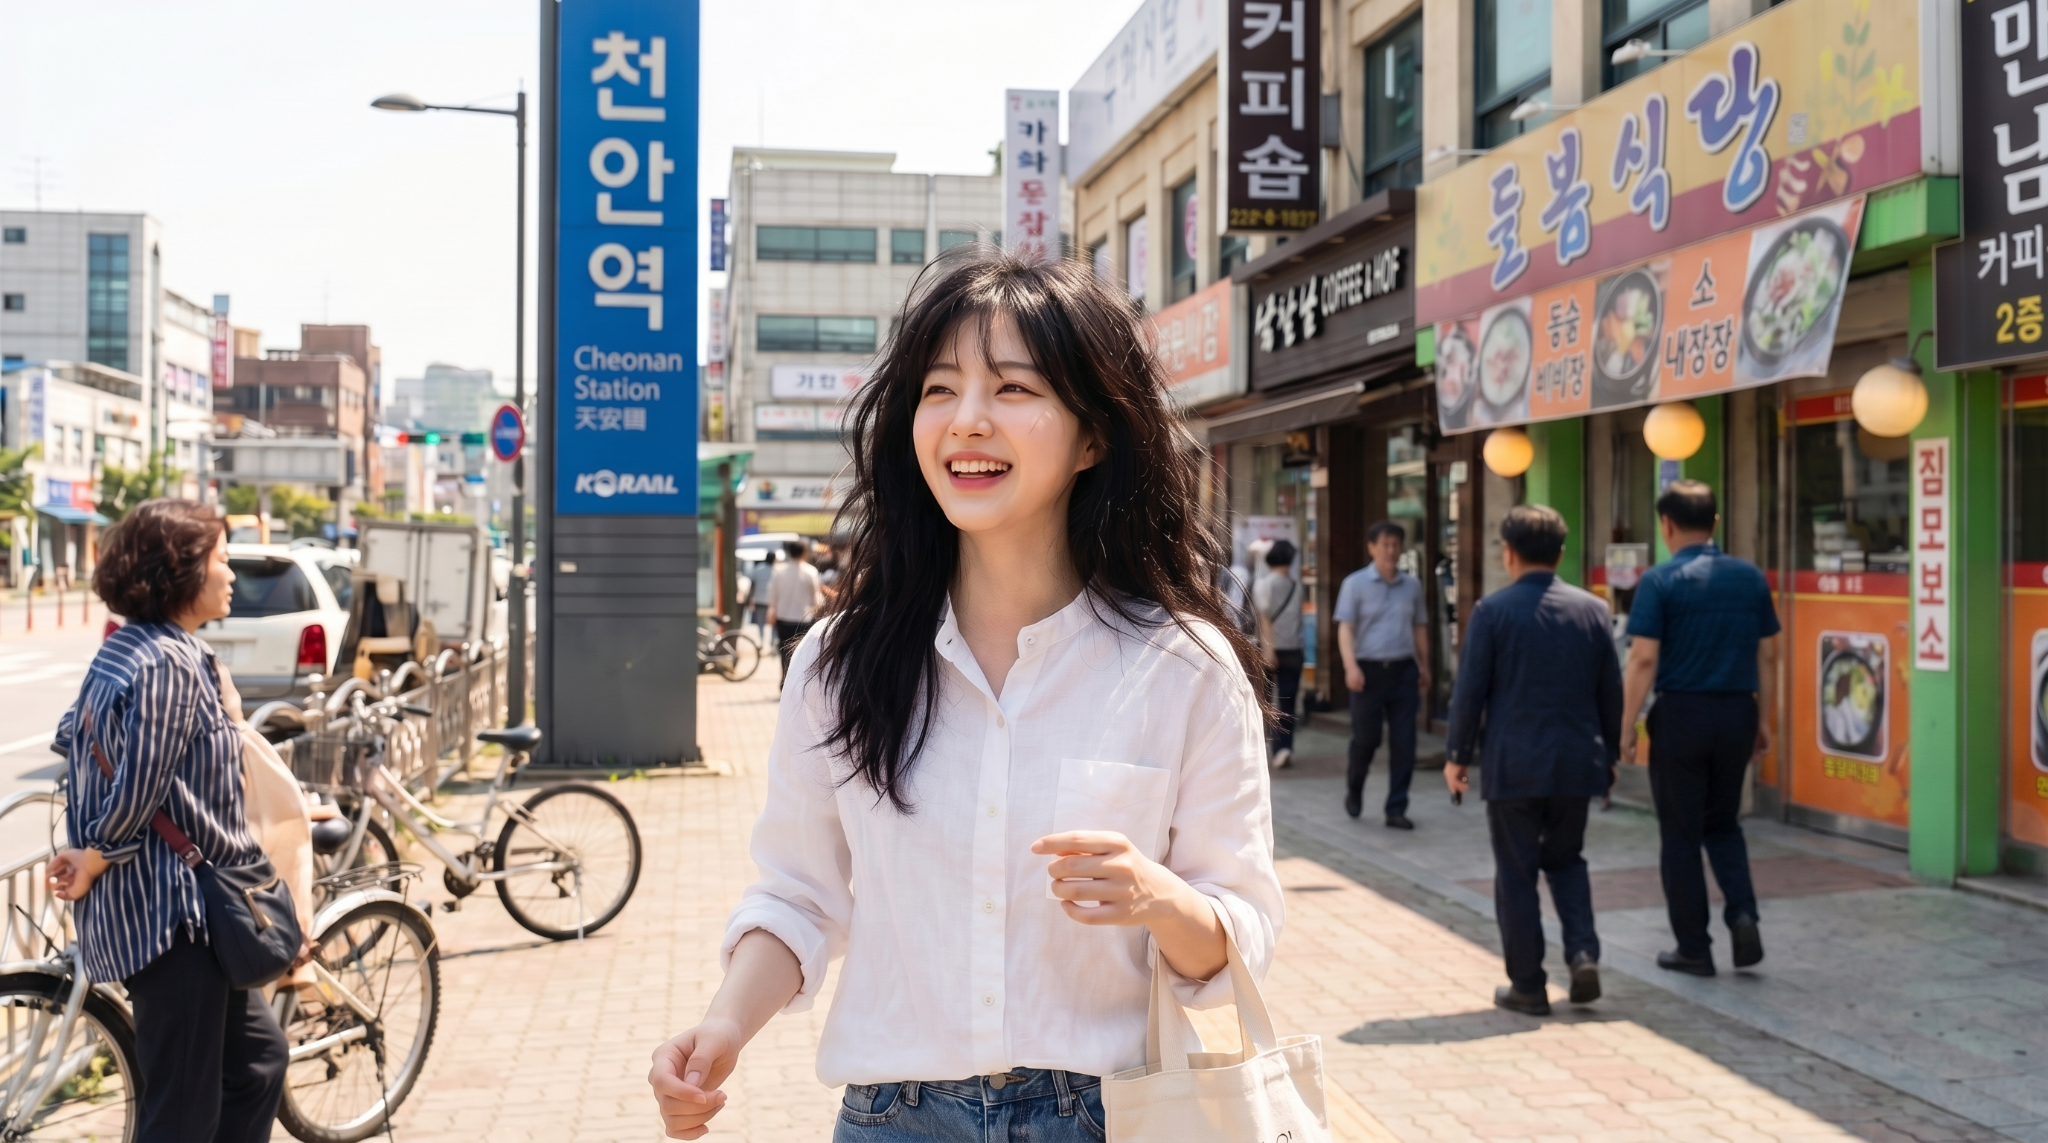
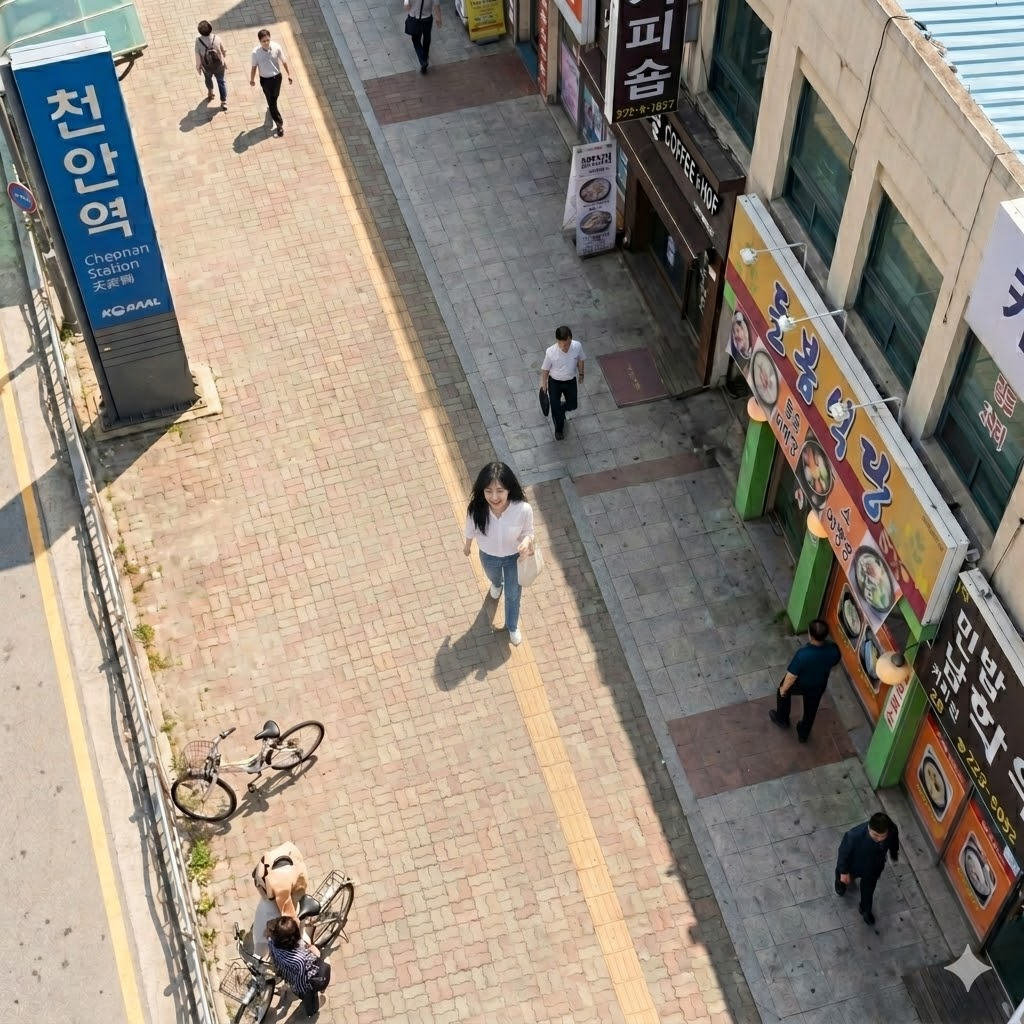
흰색 셔츠와 청바지를 입은 여성이 도시 보도를 활기차게 걸으며 미소 짓고 있다. 흰색 가방을 흔들며 "오늘은 뭘 하고 놀아볼까~?"라고 말하는 표정, 뒤로는 다채로운 간판의 상점들과 지나가는 보행자들이 보이고 햇빛이 도로를 반짝이게 비춤. 카메라는 정면에서 워킹 샷으로 따라가며 자연광 조명.
02 · 영상 생성 기초 / 텍스트 기반 영상 생성
좋은 프롬프트 vs 나쁜 프롬프트
나쁜 예 1: 너무 모호함
"걷는 여자"
어떤 대상인지, 어디인지, 어떤 샷인지, 카메라 움직임이 어떤지
AI 임의 결정.
나쁜 예 2: 이미지 프롬프트식
"아름다운 여성, 빨간 드레스, 석양, 사실적, 고화질"
움직임 정보 없음. 카메라 지시 없음. 결과가 매번 달라짐.
좋은 예
"미디엄 샷, 천천히 달리 포워드, 빨간 드레스를 입은 여성이 황금빛 석양을 배경으로 해변을 천천히 걷는다, 머리카락이 바람에 가볍게 흩날린다, 카메라가 뒤에서 따라가며 트래킹, 시네마틱, 따뜻한 색감"
샷 사이즈 명시 (미디엄 샷)
카메라 무브먼트 (달리 포워드, 트래킹)
구체적 행동 및 배경 포함
02 · 영상 생성 기초 / 텍스트 기반 영상 생성
핵심 제어 파라미터 (주요 설정값)
| 파라미터 | 의미 | 실전 팁 |
|---|---|---|
| 길이 (Duration) | 영상 길이 (초) | 5~10초가 품질이 가장 안정적 |
| 해상도 | 출력 품질 | 720p (초안) → 1080p (최종) → 2K (고급) |
| 화면 비율 | 가로/세로 비율 | 16:9 (일반), 9:16 (쇼츠/릴스), 1:1 (정방형) |
| 생성갯수 | 1~4 | 예산에 따라 적절히 선택 |
시드(Seed) 실전 활용법: 마음에 드는 결과가 나왔다면 그 seed 값을 메모해 두세요! 동일 프롬프트 + 동일 seed = 거의 같은 결과 재현 가능. 반대로 seed를 바꾸면 같은 프롬프트라도 전혀 다른 영상이 나옵니다.
02 · 영상 생성 기초 / 텍스트 기반 영상 생성
T2V의 한계 — 일관성 문제
"내가 원하는 그 사람"이 안 나온다
T2V로 영상을 여러 개 만들면 씬마다 주인공의 얼굴이 달라지고, 배경 스타일이 일관되지 않는 문제가 발생합니다.
왜 이런 문제가 생기나?
텍스트는 인물을 완벽히 고정할 수 없습니다.
"갈색 단발머리, 동그란 얼굴의 여성"
→ 세상에 이 설명에 맞는 사람은 수억 명. AI는 매번 그 중 랜덤한 한 명을 생성합니다.
씬 1: 무대 위 댄서 (여성 A)
씬 2: 댄서 클로즈업 (여성 B)
씬 3: 무대 퇴장 (여성 C)
02 · 영상 생성 기초 / 이미지 기반 영상 생성
Image-to-Video [I2V]
"이미지로 영상을 만든다"
02 · 영상 생성 기초 / 이미지 기반 영상 생성
Image-to-Video (I2V): 이미지가 살아 움직인다
T2V의 문제: 매번 새로 상상하므로 일관성 없음.
I2V의 해결: 이미지를 "출발점"으로 고정하고 거기서부터 움직임을 부여.
1
레퍼런스 이미지 업로드
2
움직임 프롬프트 입력 (예: "천천히 줌인")
3
AI가 이미지를 그대로 유지하면서 움직임만 추가
I2V의 장점
캐릭터·배경 외형의 완벽한 일관성 유지
6주차에 생성한 AI 이미지 바로 활용 가능
실제 사진도 영상화 가능
02 · 영상 생성 기초 / 이미지 기반 영상 생성
어떤 이미지를 넣어야 할까?
좋은 레퍼런스 이미지의 조건
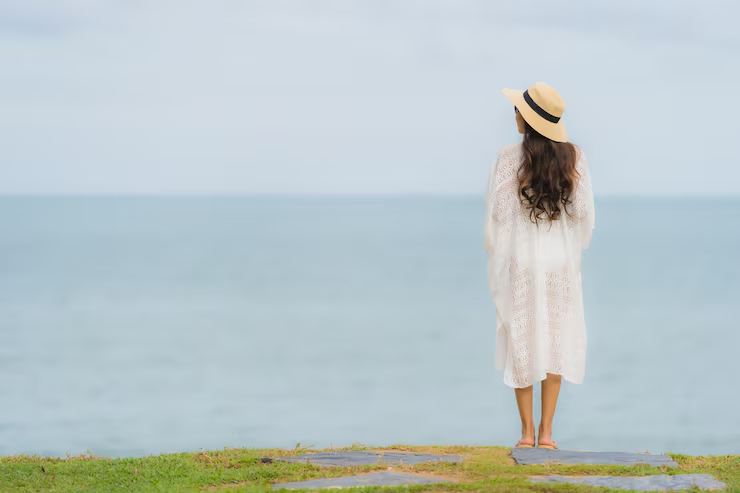
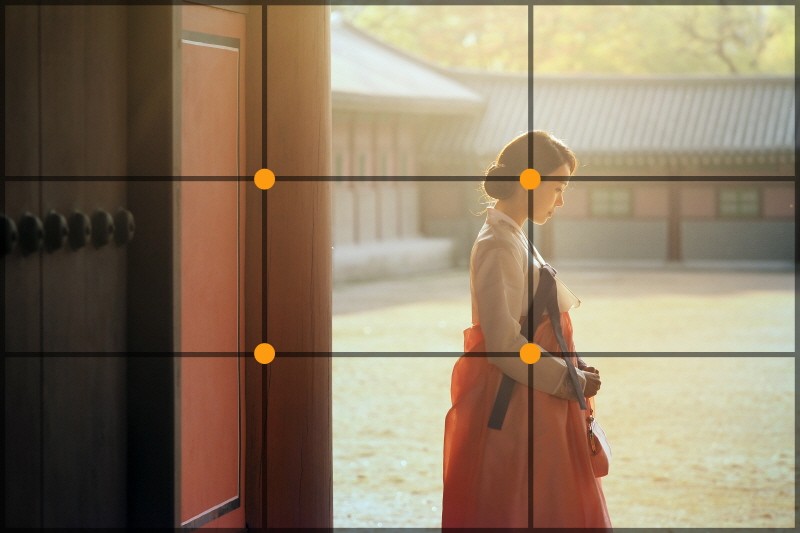
AI에게 카메라 위치와 구도를 명확히 알려주는 이미지
움직임이 발생할 공간이 확보된 프레임
원하는 무브먼트를 상상할 수 있는 구도
구체적 매칭 예시:
• 인물 풀샷: "천천히 클로즈업으로 줌인"
• 인물 클로즈업: "미세한 핸드헬드 흔들림"
• 넓은 풍경: "오른쪽으로 천천히 패닝"
01 · 제작 파이프라인 / 영상용 이미지 선별
색채 구성 영상 사례
02 · 영상 생성 기초 / 샷과 카메라
샷의 언어 (Shot Language)
AI에게 어떤 이미지를 주고, 어떻게 움직이게 할 것인가?
02 · 영상 생성 기초 / 샷과 카메라
영상의 기본 단위
시퀀스 (Sequence)
가장 큰 단위
하나의 주제나 사건을 다루는 장면들의 묶음입니다.
(예: 추격 시퀀스)
씬 (Scene)
시공간 단위
동일한 시간과 장소에서 연속적으로 일어나는 행동 단위입니다.
샷 (Shot)
촬영의 단위
카메라가 한 번 돌아가기 시작해서 멈출 때까지의 연속 촬영 단위로, AI 프롬프트의 핵심 단위입니다.
프레임 (Frame)
최소 단위
영상을 구성하는 최소 단위인 정지 이미지 1장입니다. (예: 1초 = 24 프레임)

The Holonic Structure of Moving Image
Frames, Shots, Scenes and Sequences.
(Mark Allan Kaplan, 2016)
02 · 영상 생성 기초 / 샷과 카메라
샷 사이즈 (Shot Size)의 기초
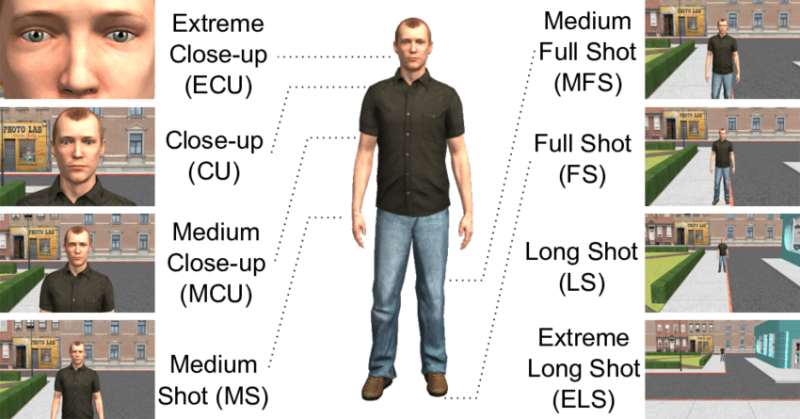
샷 사이즈란?
카메라가 피사체에 얼마나 가까이 있는가를 나타내는
'거리감의 언어'입니다.
거리감의 효과
거리가 멀수록 (Wide): 공간의 정보와 전반적인 분위기를 전달합니다.
거리가 가까울수록 (Close): 인물의 디테일과 내면의 감정을 강하게 전달합니다.
핵심 샷 구분: EWS, WS, MWS, MS, MCU, CU, ECU
02 · 영상 생성 기초 / 샷과 카메라
MS & MCU (중경 & 중클로즈업)
MS: Medium Shot (중경)
인물의 허리 위부터 머리까지 담는 영상 콘텐츠의 가장 뼈대가 되는 기본 샷입니다.
관객이 인물과 마주 앉아있는 듯한 가장 일상적이고 편안한 거리감을 주며, 대화 씬이나 설명 씬에 최적화되어 있습니다.
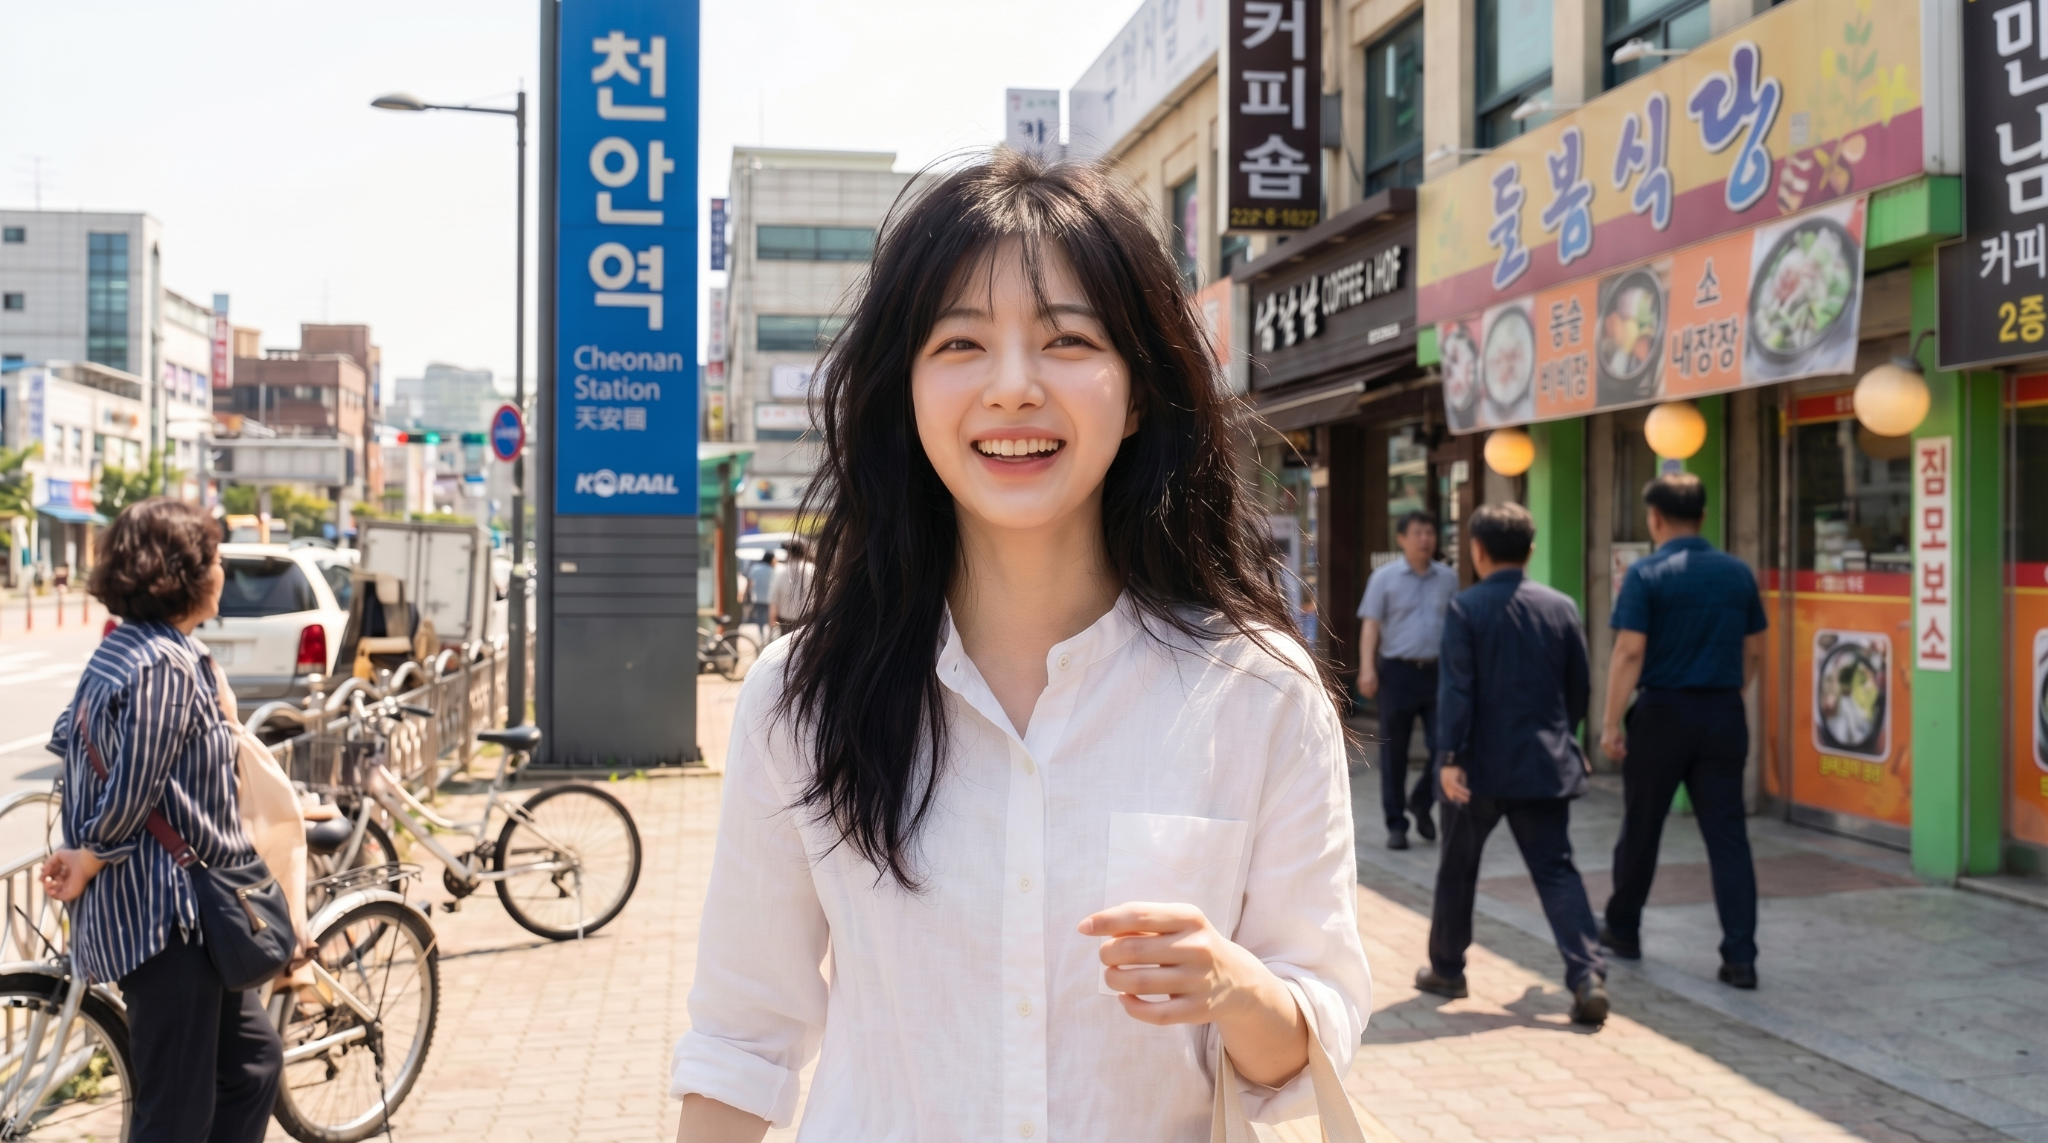
MCU: Medium Close-Up
인물의 가슴 위부터 머리까지 담아 표정을 조금 더 강조하는 샷입니다.
뉴스 앵커, 인터뷰, 그리고 드라마에서 감정이 섞인 대화를 나눌 때 가장 많이 쓰이는 표준적인 클로즈 대화 샷입니다.
02 · 영상 생성 기초 / 샷과 카메라
EWS & WS (극원경 & 원경)

EWS: Extreme Wide Shot (극원경)
피사체가 환경에 완전히 묻혀 보일 정도로 넓게 찍은 샷
장소의 규모, 피사체의 고독함 표현
오프닝 샷(Establishing shot)에 주로 사용
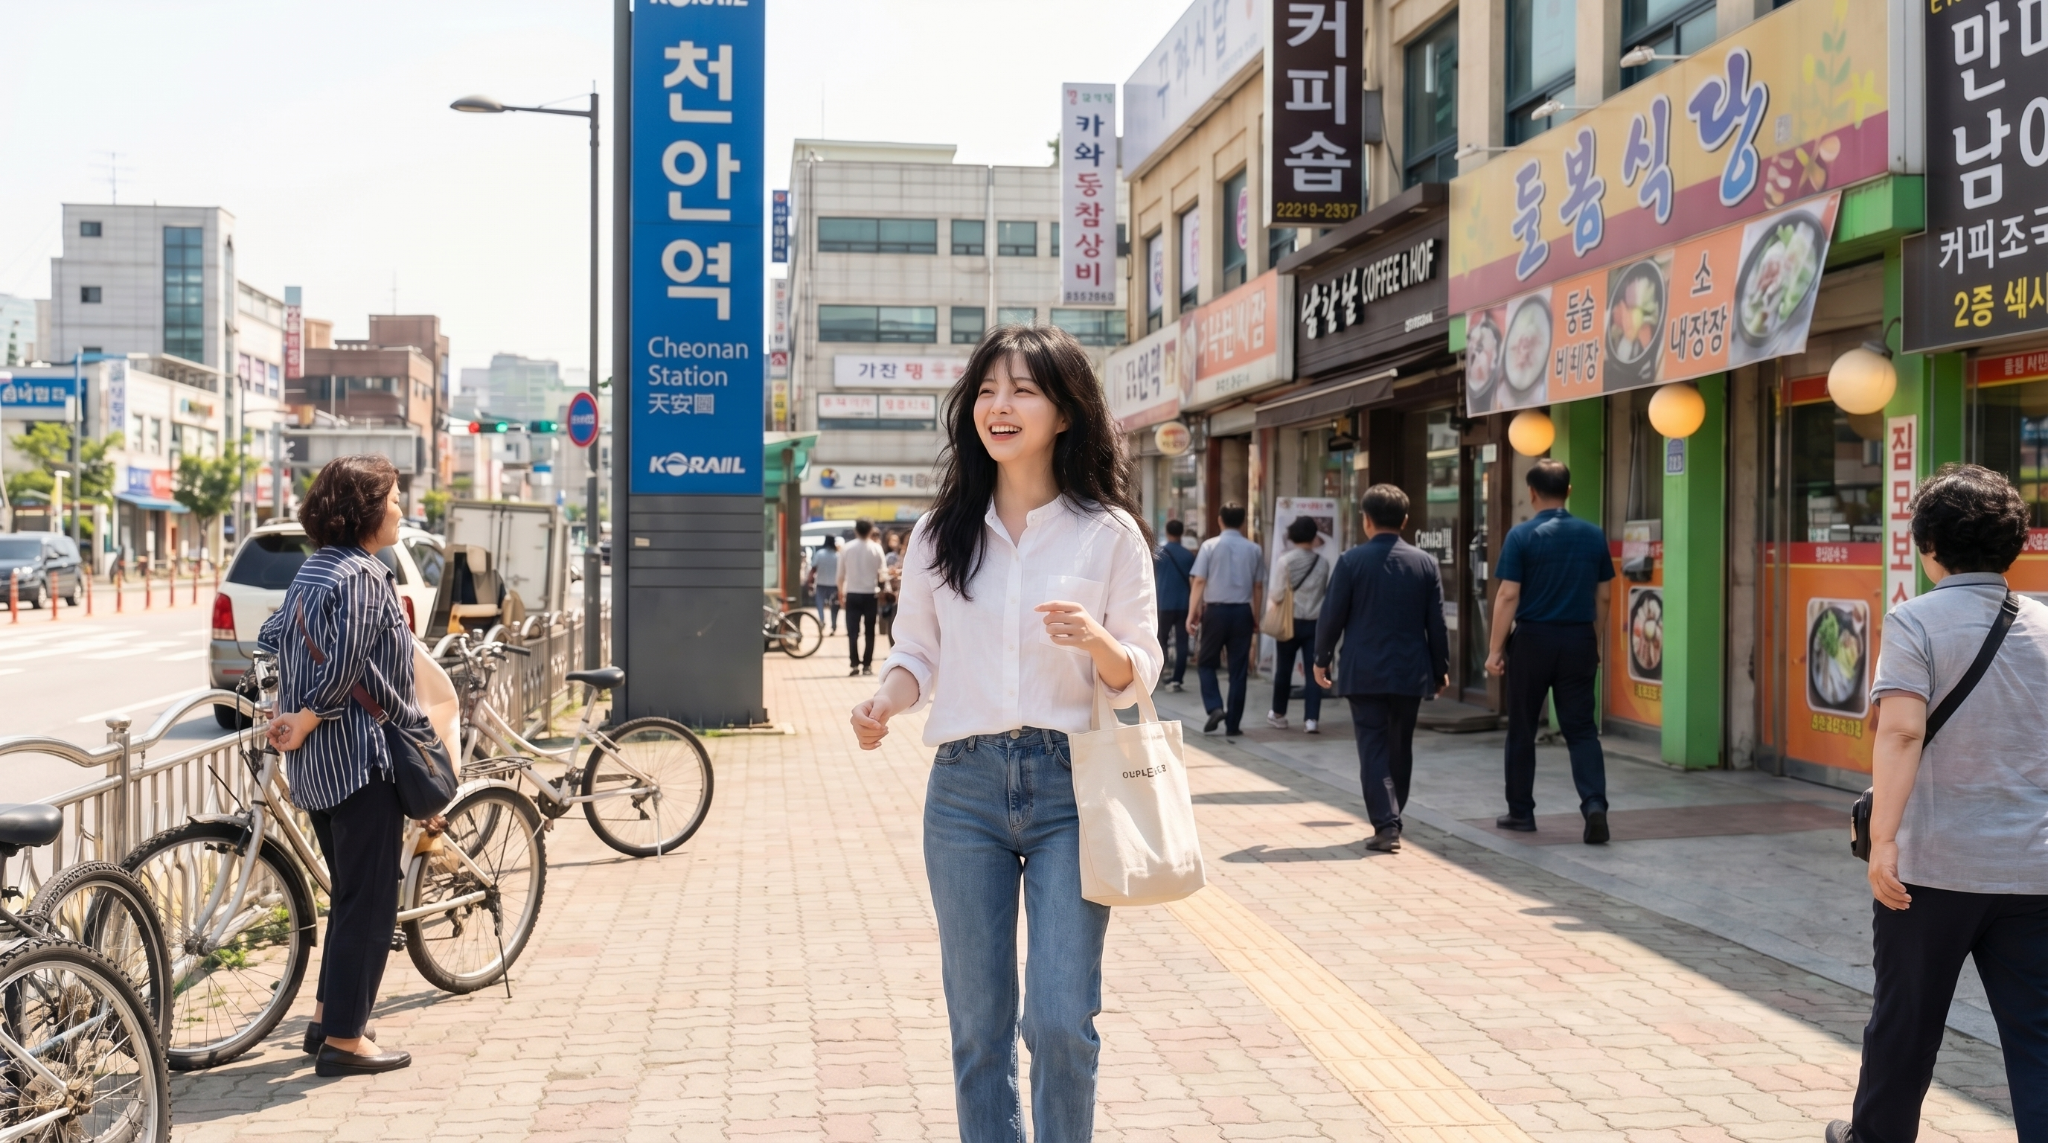
WS: Wide Shot (원경/풀샷)
인물의 발끝부터 머리까지 전신이 모두 담기는 샷
인물의 전체적인 동작, 신체 언어 묘사에 최적
주변 환경과의 관계를 동시에 보여줌
02 · 영상 생성 기초 / 샷과 카메라
CU & ECU (근경 & 극근경)

CU: Close-Up (근경)
어깨 위부터 얼굴 전체를 화면에 꽉 차게 담는 샷
감정의 클라이맥스 (눈물, 미소, 긴장) 표현
중요한 단서나 사물을 관객에게 강제 집중시킬 때

ECU: Extreme Close-Up
눈, 입술, 손가락 등 신체 일부나 사물을 극도로 확대하는 샷
(Macro Shot)
극단적인 공포, 불안감 등 심리 상태 묘사
감각적이고 예술적인 시네마틱 연출에 사용
02 · 영상 생성 기초 / 샷과 카메라
특수 목적 샷 4가지
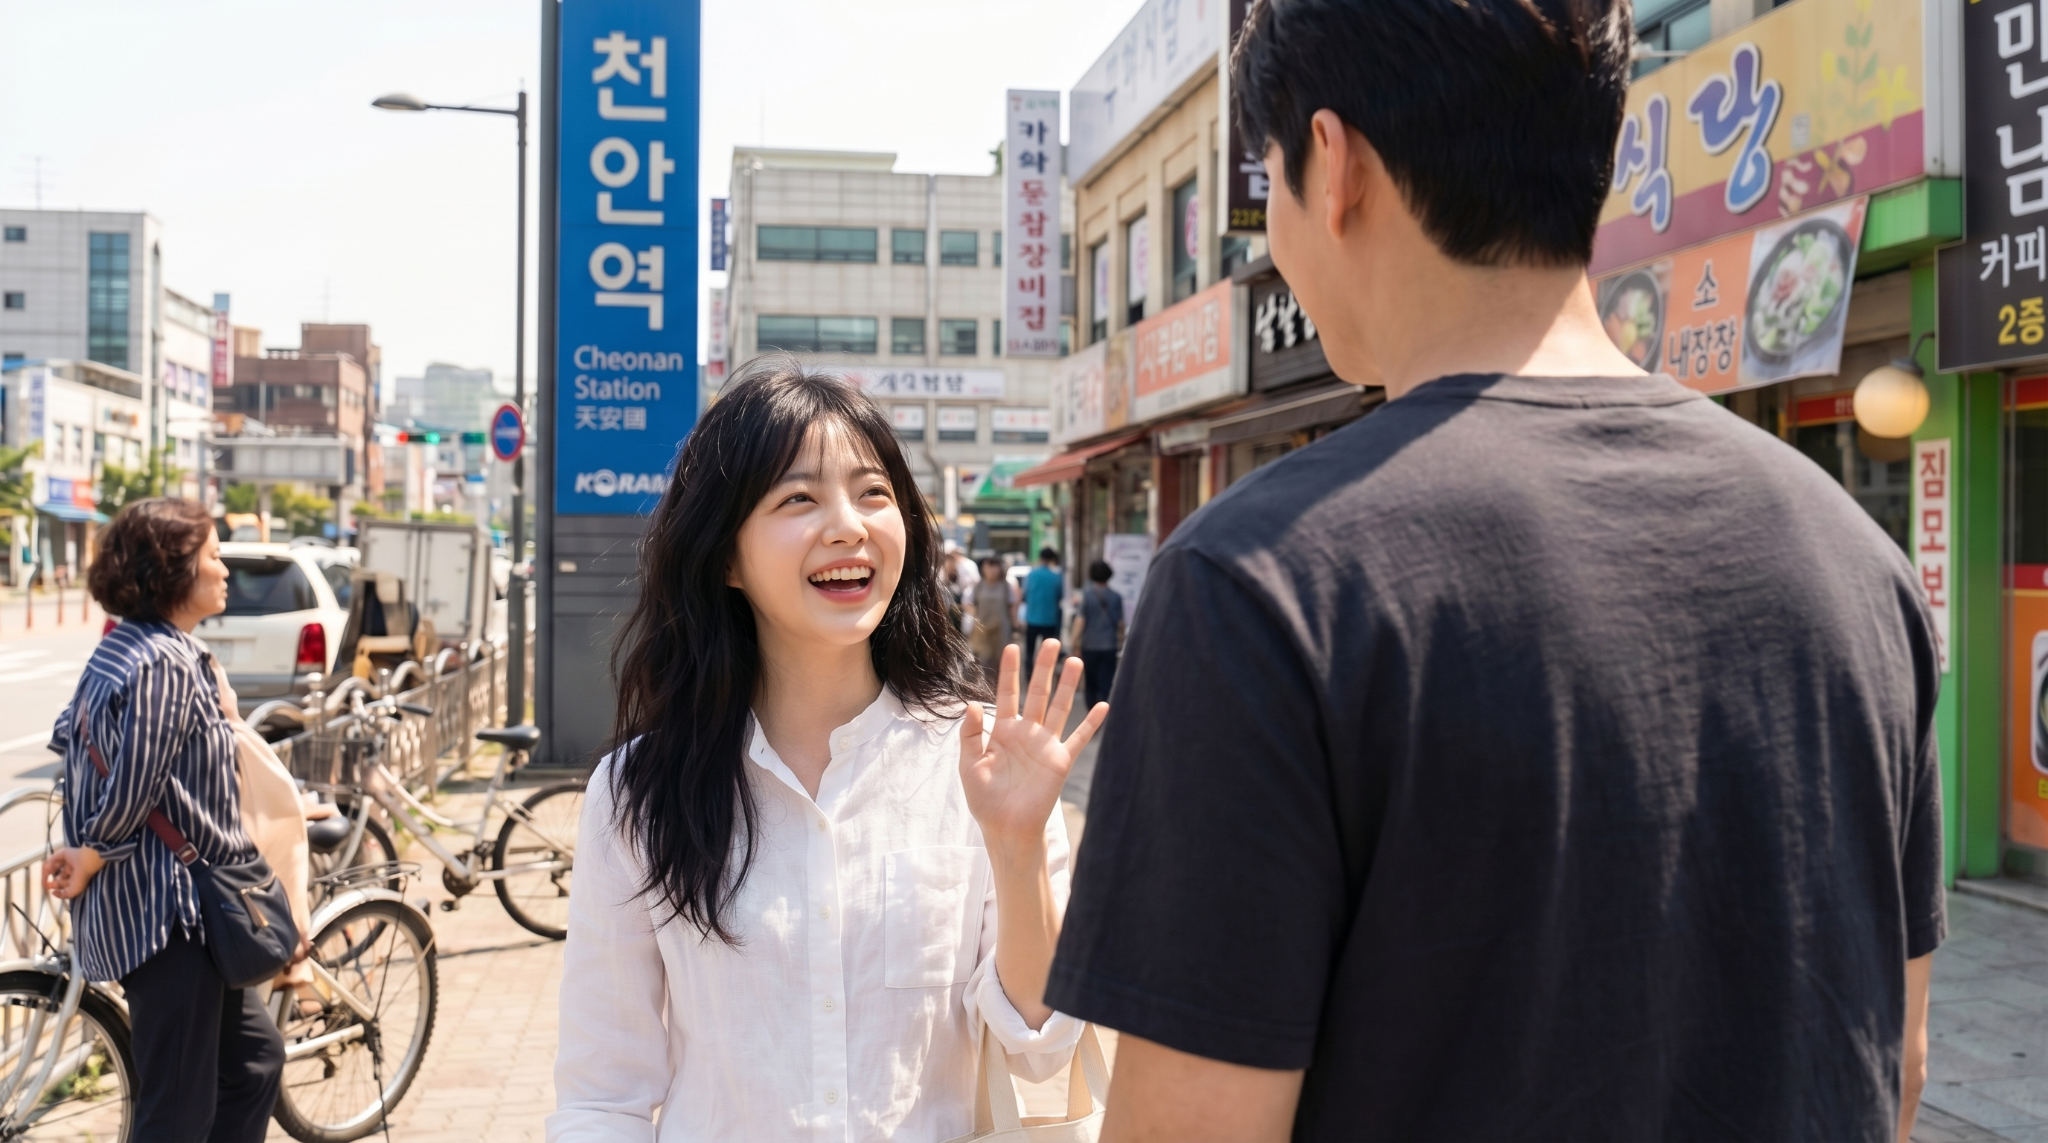
Shoulder Shot (숄더샷)
인물의 뒷모습과 그가 바라보는 피사체가 화면에 함께 걸쳐 나오는 샷

Two Shot (투샷)
두 인물이 한 프레임 안에 함께 등장하여 둘 사이의 관계나 갈등을 보여주는 샷
02 · 영상 생성 기초 / 샷과 카메라
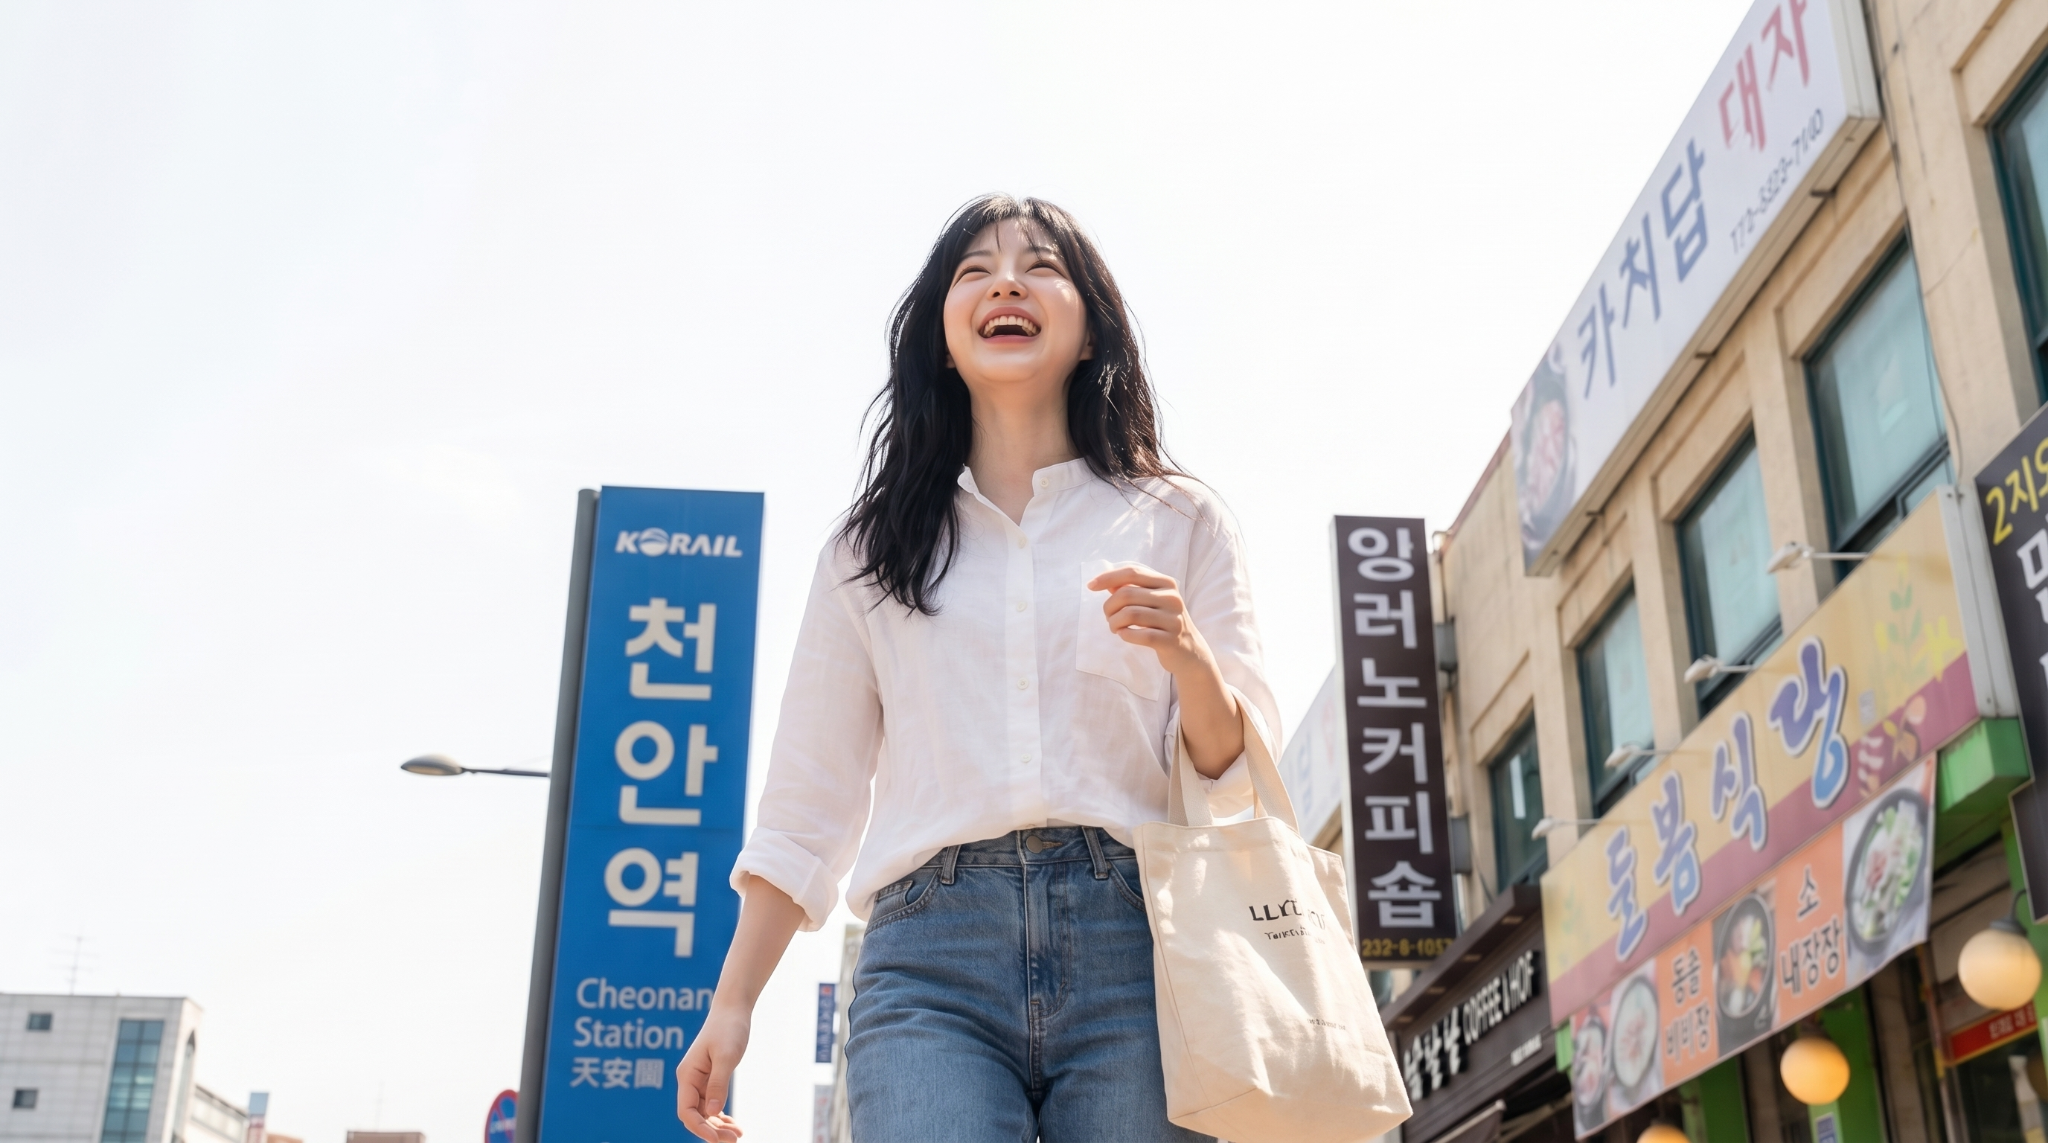
카메라 앵글 — 눈높이와 기울기
앵글이 감정에 미치는 영향
같은 장면도 카메라 위치에 따라 완전히 다른 감정을 전달합니다.
Eye-Level (아이레벨): 인물과 같은 눈높이. 가장 중립적이고 자연스러운 시선입니다.
Low Angle (로우 앵글): 아래에서 올려다봄. 피사체가 크고 강하게 보이며 위압감을 줍니다.
High Angle (하이 앵글): 위에서 내려다봄. 피사체가 작고 취약해 보입니다.
Bird's Eye View: 완전히 수직(90도)으로 내려다보는 샷입니다.
Dutch Angle (더치 앵글): 카메라를 15~45도 비스듬히 기울여 불안, 혼란, 긴장감을 유발합니다.

02 · 영상 생성 기초 / 샷과 카메라
카메라 무브먼트의 이해
왜 카메라를 움직이는가?
정지된 카메라(Fix)는 AI 영상을 단순한 '2D 사진의 슬라이드쇼'처럼 보이게 만들어 지루함을 줍니다.
카메라 무브먼트의 3대 효과
3D 공간감 확보: 카메라가 이동하면 배경의 원근감이 달라지며 완벽한 입체감이 생깁니다.
시선 유도: 감독의 의도대로 관객이 봐야 할 숨겨진 곳을 서서히 보여줍니다.
에너지 전달: 빠르고 역동적인 무브먼트는 액션의 속도감과 긴장감을 배가시킵니다.
02 · 영상 생성 기초 / 샷과 카메라
고정 축 무브먼트 (Pan / Tilt / Zoom)
Pan (팬 / 패닝)
"제자리에서 도리도리"
카메라 위치는 고정한 채, 고개만 좌/우로 돌리는 움직임입니다. 넓은 풍경을 훑거나 지나가는 대상을 시선으로 따라갈 때 사용합니다.
Tilt (틸트)
"제자리에서 끄덕끄덕"
카메라 위치는 고정한 채, 고개만 상/하로 끄덕이는 움직임입니다. 높은 빌딩을 올려다보거나 인물의 전신을 위아래로 훑어볼 때 사용합니다.
Zoom (줌)
"화각의 변화"
위치는 고정된 상태에서 렌즈의 화각만 좁히거나 넓혀 대상이 가까워지거나 멀어지게 만드는 렌즈 조작 무브먼트
입니다.
02 · 영상 생성 기초 / 샷과 카메라
물리적 이동 (Dolly / Crane / Handheld)
Dolly (달리 / 트래킹)
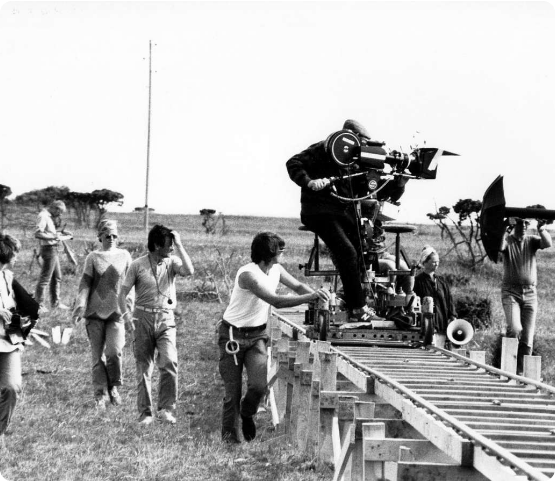
카메라 자체가 피사체를 향해 레일을 타고 앞뒤(In/Out) 또는 좌우로 물리적으로 전후진하는 움직임입니다.
피사체 내부로 빨려 들어가는 듯한 몰입감과 3D 입체감을 가장 잘 살려줍니다.
Crane (크레인/페데스탈)
기둥이나 크레인 장비를 이용해 카메라 전체가 크게 수직으로 승강(Up/Down)하는 움직임입니다.
수직적인 스케일감을 부여하거나 벽 너머의 새로운 시야를 천천히 제공할 때 쓰입니다.
Handheld (핸드헬드)
삼각대 없이 손에 들고 찍어 미세한 흔들림이 지속적으로 발생하게 하는 촬영 기법입니다.
다큐멘터리 특유의 거친 현장감, 인물의 불안정함, 긴박한 추격전 연출에 필수적입니다.
02 · 영상 생성 기초 / 영상 변환
Video-to-Video [V2V]
"영상으로 영상을 만든다"
02 · 영상 생성 기초 / 영상 변환
V2V: 영상을 영상으로 (Video-to-Video)
기존 영상을 AI로 변환하다
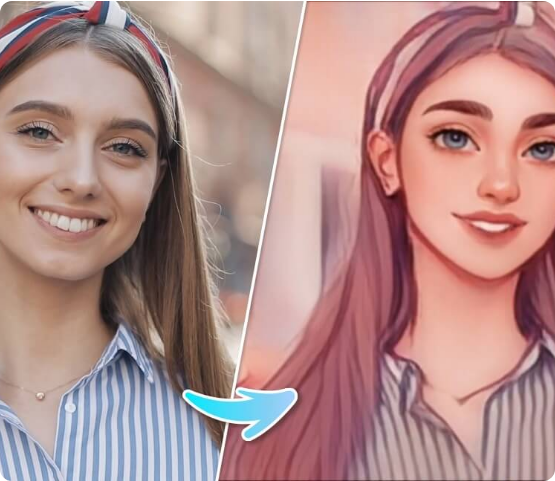
입력된 원본 영상의 동작과 구도를 AI가 인식한 뒤, 새로운 스타일이나 캐릭터로 덮어씌워 완전히 새로운 영상을 만들어냅니다.
V2V의 주요 활용 유형
스타일 변환: 실사 촬영본 → 애니메이션 / 수채화 스타일로 변경
모션 전이: A의 춤선이나 움직임을 B 캐릭터에 그대로 적용
캐릭터/배경 교체: 영상 속 인물을 AI 캐릭터로 바꾸거나 배경만 변경
품질 향상: 저화질 렌더링을 고화질로 복원하거나 흑백을 컬러로 변환
02 · 영상 생성 기초 / 영상 변환
V2V 최근 동향 & 밈(Meme) 제작
왜 지금 V2V가 가장 핫한가?
기존에는 영상의 일관성을 유지하며 동작만 바꾸는 것이 기술적으로 매우 어려웠으나, 2025년 이후 AI 모델들이 실용화 수준에 도달하며 숏폼 콘텐츠와 맞물려 폭발적으로 성장했습니다.
실제 바이럴 사례 유형:
유명 댄스 챌린지 원본 영상에 자신의 얼굴이나 완전히 새로운 3D 캐릭터를 V2V로 입혀 틱톡(TikTok)이나 릴스에 업로드하는 방식.
주의사항: 타인의 영상을 무단으로 V2V 변환할 경우 저작권 및 초상권 침해 소지가 매우 높습니다. 딥페이크 악용에 대한 규제도 강화되고 있습니다.
02 · 영상 생성 기초 / 영상 변환
V2V의 기술적·실용적 한계
아직 넘지 못한 벽들
V2V는 가장 빠르게 발전 중인 영역이지만, 여전히 기술적 제약이 존재합니다.
아티팩트: 변환 과정에서 화면이 찢어지거나 번짐, 깜빡임(Flickering)이 발생합니다.
드리프트(Drift): 영상이 30초 이상 길어질수록 품질이 서서히 무너지며 이상하게 변합니다.
디테일 손실: 손가락, 눈동자, 배경의 텍스트 글자들이 뭉개지기 쉽습니다.
복잡도 한계: 사람이 너무 많거나 배경이 복잡하면 처리가 불안정해집니다.
02 · 영상 생성 기초 / 제작 도구
영상 생성 실습
"나만의 이야기를 인공지능을 활용하여 생성"
02 · 영상 생성 기초 / 제작 도구
사례 연구: 선두주자 Sora의 명(明)과 암(暗)
AI 분야에서는 "처음 잘 했다"는 것이 "영원히 1등"을 보장하지 않습니다. 기술의 흐름을 읽어야 합니다.
명(明): 세상을 바꾼 순간
2024년 2월, OpenAI가 Sora 데모를 최초 공개했습니다.
기존 3~4초 수준이던 시장에 물리 법칙이 완벽한 60초 영상을 선보이며 충격을 주었습니다.
모든 경쟁사가 Sora를 타겟으로 삼게 만들며, '영상 생성 시대'를 사실상 혼자 열어젖힌 개척자입니다.
암(暗): 왜 1위가 0위가 되었나
2026년 4월 26일, Sora 웹앱 서비스 종료 예정
너무 늦은 출시: 데모 공개 후 1년이나 지나 정식 출시하는 동안 경쟁자들이 모두 기술을 따라잡았습니다.
품질 저하 논란: 서비스 스케일업 과정에서 데모 영상만큼의 압도적인 퀄리티가 나오지 않았습니다.
비싼 구독료와 폐쇄적인 기능 제약으로 대중화에 실패했습니다.
강의 원본: 2026년 4월
02 · 영상 생성 기초 / 제작 도구
참고 자료
https://www.figma.com/board/Tx3SkMFIxnD4ecQ3Gr4Ktq/%EC%A0%9C%EB%AA%A9-%EC%97%86%EC%9D%8C?node-id=0-1&t=YmAXlHOqHMFyf59G-1
https://drive.google.com/file/d/1D-cMPA6Ycw30hYmfUtdoJyZnQ_0MrBrS/view